결측치는 값이 비어 있는 자리다. 그런데 "어떻게 채울까"가 아니라 "왜 비었을까". 왜 비었는지에 따라 올바른 처리가 달라지기 때문에, 원인을 먼저 나눈 다음 방법을 고른다.
이 글은 결측이 생기는 세 가지 원인을 구분하고, 그에 따라 정답을 알고 있는 상태에서 각 처리 방법이 얼마나 틀리는지 판단하는 기준을 정리한다.
결측이 생기는 세 가지 원인
결측을 분류하는 기준은 "무엇이 결측을 만들었는가"다. 아무것도 아닌지, 다른 변수인지, 아니면 비어 있는 값 그 자체인지에 따라 세 가지로 나뉜다.
import pandas as pd
from urllib.request import Request, urlopen
URL = “https://1000page.pages.dev/data/game-users.csv” request = Request(URL, headers={“User-Agent”: “Mozilla/5.0”}) with urlopen(request, timeout=30) as response: df = pd.read_csv(response)
print(df.shape)
(4030, 14)Missing Completely At Random. 결측의 발생이 어떤 변수와도 관련이 없는 경우다. 누가 비었는지에 규칙이 없다.
urlopen에
User-Agent를 붙이는 이유는 일부 CDN이 기본 파이썬 요청을 막기 때문이다. 로컬 파일이라면pd.read_csv("game-users.csv")처럼 경로만 넣으면 된다.
전산 오류, 통신 장애, 장비 고장처럼 사람의 특성과 무관한 사고로 생긴 결측이 여기에 해당한다. 남은 데이터는 전체의 축소판이므로, 세 유형 중 가장 다루기 쉽다.
MAR — 조건부 무작위 결측
isna()는 값이 비어 있으면 True를 돌려준다. 여기에 sum()을 쓰면 개수가, mean()을 쓰면 비율이 나온다. 두 값을 한 표로 묶는다.
                  결측수  결측률(%)
review_score     2187    54.3
review_text_len  2187    54.3
last_login_date  1481    36.7
gender            680    16.9
age               195     4.8
country            81     2.0
이름이 헷갈리기 쉬운데, 가장 먼저 눈여겨볼 것은 맨 위 두 줄의 결측수가 2187로 똑같다는 점이다. 30대 남성 집단 안에서는 누가 비울지 규칙이 없다. 그래서 성별과 연령대를 알고 있으면 결측을 설명할 수 있다.
핵심은 결측을 설명하는 정보가 데이터 안에 이미 있다는 점이다. 성별과 연령대는 관측되어 있으므로, 이 정보를 써서 빈자리를 합리적으로 추정할 수 있다.
MNAR — 비무작위 결측
결측치를 만나면 dropna()가 가장 먼저 떠오른다. 실행하기 전에 비용부터 계산해야 한다.
print(f"전체 행: {len(df)}")
print(f"결측이 하나라도 있는 행: {df.isna().any(axis=1).sum()}")
print(f"완전한 행(dropna 후): {df.dropna().shape[0]}")
전체 행: 4030
결측이 하나라도 있는 행: 3046
완전한 행(dropna 후): 984Missing Not At Random. 행 단위로 지우면 4,030행이 984행으로 줄어든다다.
예) 용돈 설문에서 소득이 낮은 사람일수록 응답을 비웠다. 소득이 적다는 사실이 부끄러워 답하지 않은 것이라면, 알고 싶은 값(소득)이 곧 결측의 원인이다.
MAR과의 차이가 여기서 갈린다. MAR은 "30대 남성이라서" 비웠고, MNAR은 "소득이 낮아서" 비웠다. 전자는 데이터에 있는 정보(성별·연령)로 설명되지만, 후자는 비어 있어서 볼 수 없는 값이 원인이다.
그래서 MNAR은 데이터만 봐서는 확인할 수 없다. 사라진 값을 볼 수 있다면 애초에 결측이 아니기 때문이다. 설문 주제가 민감하거나, 응답이 자발적일 때 의심한다.
3단계: 어떤 열이 함께 비는지 본다
1단계에서 발견한 "결측수 2187 일치"를 확인할 차례다. isna()로 만든 True/False 표에 corr()을 걸면 결측이 함께 발생하는 정도가 상관계수로 나온다.
na = df.isna()
print(na.loc[:, na.any()].corr().round(2))
age gender country last_login_date review_score review_text_len
age 1.00 0.01 -0.02 0.02 0.03 0.03
gender 0.01 1.00 0.01 0.02 0.02 0.02
country -0.02 0.01 1.00 -0.02 -0.01 -0.01
last_login_date 0.02 0.02 -0.02 1.00 0.08 0.08
review_score 0.03 0.02 -0.01 0.08 1.00 1.00
review_text_len 0.03 0.02 -0.01 0.08 1.00 1.00review_score와 review_text_len의 상관이 1.00이다. 대각선(자기 자신과의 상관)을 빼면 이 값만 1이다. 나머지 조합은 모두 0에 가깝다.
교차표로 확인하면 더 분명하다.
print(pd.crosstab(df["review_score"].isna(), df["review_text_len"].isna()))review_text_len False True
review_score
False 1843 0
True 0 2187대각선이 아닌 칸이 모두 0이다. 한쪽만 비어 있는 행은 단 하나도 없다. 리뷰를 쓰지 않은 유저는 점수도 글자 수도 없으니 당연한 결과다.
숫자 대신 그림으로 보면 더 빠르다. 결측 위치를 그대로 찍으면 흰 줄이 곧 빈자리다.
import matplotlib.pyplot as plt

na_cols = df.columns[df.isna().any()]
order = df[na_cols].isna().sum().sort_values(ascending=False).index

plt.figure(figsize=(9, 5))
# notna()가 True(값 있음)인 곳을 진하게 칠한다 → 흰 줄이 결측이다
plt.imshow(df[order].notna(), aspect="auto", cmap="binary", interpolation="nearest")
plt.xticks(range(len(order)), order, rotation=30, ha="right")
plt.tight_layout()
plt.show()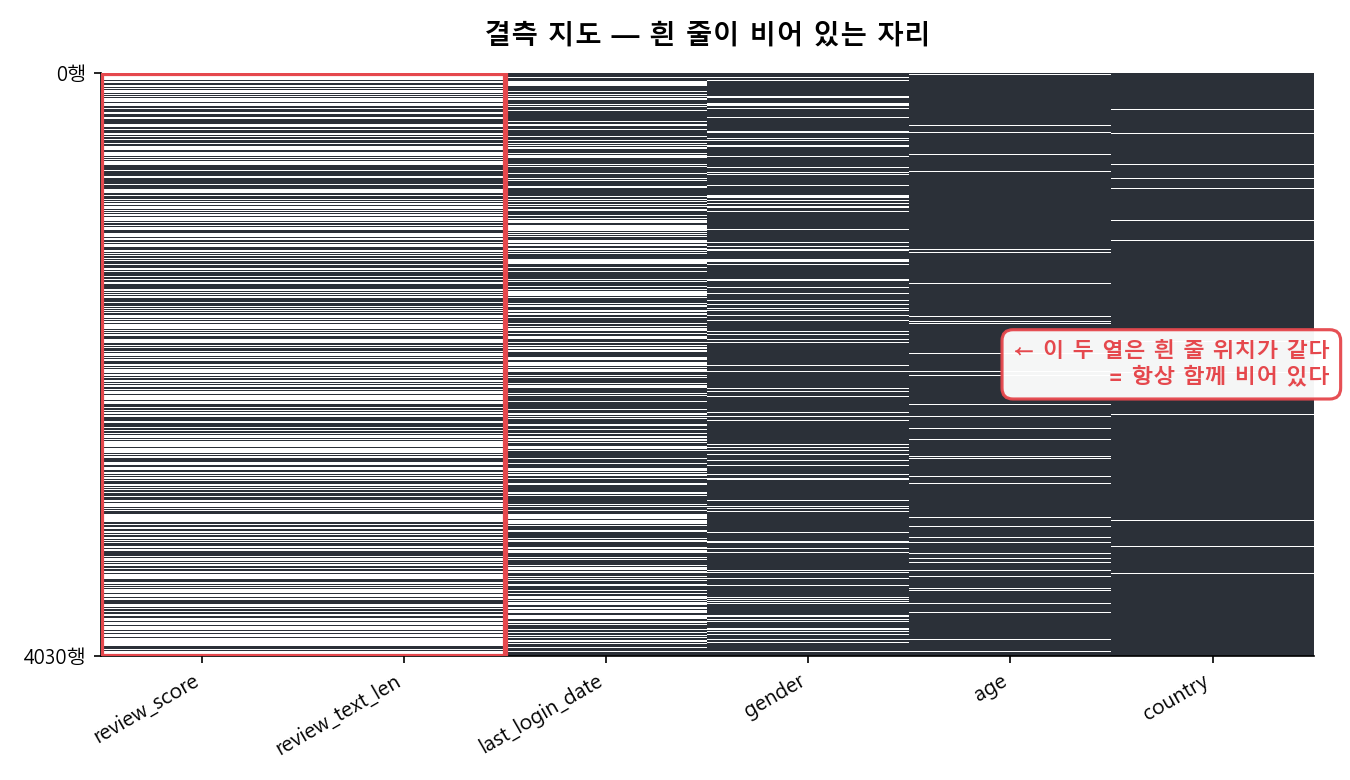
왼쪽 두 열은 흰 줄 패턴이 완전히 겹친다. 오른쪽 열들은 서로 무관하게 흩어져 있다.
이런 열은 따로 처리하면 안 된다. 한쪽만 채우면 "리뷰 점수는 있는데 글자 수는 0"인 모순된 행이 생긴다. 함께 지우거나, 함께 남기거나, wrote_review 같은 파생 변수 하나로 묶는 편이 낫다.
4단계: 결측의 원인을 세 가지로 나눈다
여기서부터는 코드로 답이 나오지 않는다. 결측은 원인에 따라 세 유형으로 나뉘고, 유형마다 올바른 처리가 다르다. 먼저 각 유형이 무엇인지 정리한다.
분류 기준은 "무엇이 결측을 만들었는가"다. 아무것도 아닌지, 다른 변수인지, 아니면 비어 있는 값 그 자체인지에 따라 갈린다.
실무에서 세 유형을 확실히 구분하는 검정 방법은 없다. MCAR인지 아닌지는 데이터로 확인할 수 있지만, MAR과 MNAR의 구분은 데이터 밖의 지식이 필요하다. 설문 설계, 수집 과정, 도메인 경험을 근거로 판단한다.
유형에 따라 처리가 달라지는 이유
같은 5% 결측이라도 원인이 다르면 결과가 달라진다. 용돈 설문을 예로 들면 이렇다.
MCAR이면 비운 사람들이 전체와 비슷한 사람들이다. 지워도 남은 데이터의 성격이 그대로다.
MAR이면 30대 남성이 적게 남는다. 그대로 지우면 표본에서 30대 남성 비중이 줄어든다. 대신 성별·연령별로 나눠 채우면 상당 부분 보정된다.
MNAR이면 저소득층이 적게 남는다. 지우면 평균 소득이 실제보다 높아지고, 관측된 값으로 채워도 마찬가지로 높아진다. 어느 쪽도 편향을 없애지 못한다.
정리하면 MCAR은 삭제해도 되고, MAR은 채우는 편이 낫고, MNAR은 어느 쪽도 답이 아니다.
결측값 삭제
결측이 있는 행이나 열을 제거하는 방법이다. 값을 새로 만들어 내지 않으므로 가장 단순하고 왜곡의 소지가 적다.
MCAR — 완전 무작위 결측
Missing Completely At Random. 결측의 발생이 어떤 변수와도 관련이 없는 경우다. 누가 비었는지에 규칙이 없다.
예)
age가 4.8% 비어 있다. 프로필 서버에 장애가 있던 동안 가입한 유저의 나이가 저장되지 않았다. 하필 그 시간에 가입했을 뿐, 그 유저가 누구인지와는 무관하다.
실제로 이 데이터에서 age의 결측률은 이탈 유저 5.1%, 잔존 유저 4.6%로 거의 같다. 어떤 기준으로 나눠도 비슷한 비율이 나온다면 MCAR을 의심할 근거가 된다.
서버 장애, 통신 오류, 로그 유실처럼 유저의 특성과 무관한 사고로 생긴 결측이 여기에 해당한다. 남은 데이터는 전체의 축소판이므로 세 유형 중 가장 다루기 쉽다.
MAR — 조건부 무작위 결측
Missing At Random. 결측의 발생이 특정 변수와는 관련 있지만, 알고 싶은 값과는 관련이 없는 경우다.
예)
last_login_date가 이탈 유저에서 62.7%, 잔존 유저에서 6.4% 비어 있다. 이탈해서 접속 기록이 정리된 것이다. "이탈했다"는 특성과 결측은 분명히 관련이 있다. 하지만 그 유저가 마지막으로 언제 접속했는지와는 무관하게 비었다. 3개월 전에 떠났든 1년 전에 떠났든 똑같이 비어 있다.
이름이 헷갈리기 쉬운데, "무작위"는 그룹 안에서 무작위라는 뜻이다. 이탈 유저 집단 안에서는 누구의 기록이 남고 누구의 기록이 사라질지 규칙이 없다. 그래서 churn_flag를 알고 있으면 결측을 상당 부분 설명할 수 있다.
핵심은 결측을 설명하는 정보가 데이터 안에 이미 있다는 점이다. churn_flag는 비어 있지 않으므로, 이 열로 그룹을 나눠 빈자리를 다루면 된다.
MNAR — 비무작위 결측
Missing Not At Random. 비어 있는 값 자체가 결측의 원인인 경우다.
예)
review_score가 54.3% 비어 있다. 그런데 게임이 재미없다고 느낀 유저일수록 리뷰를 쓰지 않고 조용히 떠난다. 그렇다면 알고 싶은 값(만족도)이 곧 결측의 원인이다. 낮은 점수가 선택적으로 사라진다.
MAR과의 차이가 여기서 갈린다. last_login_date는 "이탈해서" 비었고, review_score는 "불만족해서" 비었다. 전자는 데이터에 있는 churn_flag로 설명되지만, 후자는 비어 있어서 볼 수 없는 값이 원인이다.
그래서 MNAR은 데이터만 봐서는 확인할 수 없다. 사라진 평점을 볼 수 있다면 애초에 결측이 아니기 때문이다. 리뷰·설문·별점처럼 응답이 자발적인 항목은 늘 MNAR을 의심한다.
이 예제 데이터에는 결측이 없는 정답지가 함께 있어서 실제로 확인할 수 있다. 관측된 평점의 평균은 3.44지만 전체 유저의 실제 평균은 3.17이다. 리뷰를 쓴 사람만 보고 "만족도가 괜찮다"고 판단하면 0.27점을 과대평가하게 된다.
세 유형 비교
유형 | 결측을 만든 원인 | 이 데이터의 예 | 복구 가능성 |
|---|---|---|---|
MCAR | 없음 (우연) | 서버 장애로 age 유실 | 쉬움 |
MAR | 관측된 다른 변수 | 이탈해서 last_login_date가 없음 | churn_flag로 추정 가능 |
MNAR | 비어 있는 값 자체 | 불만족해서 review_score를 안 남김 | 데이터만으로는 불가 |
앞서 3단계까지 확인한 것이 이 판단의 근거가 된다. 집단별 결측률에 차이가 없으면 MCAR을, 특정 집단에서 뛰면 MAR을 의심한다. 관측된 값의 분포가 한쪽으로 치우쳐 있으면 MNAR을 의심한다.
다만 세 유형을 확실히 구분하는 검정 방법은 없다. MCAR인지 아닌지는 데이터로 확인할 수 있지만, MAR과 MNAR의 구분에는 데이터 밖의 지식이 필요하다. 설문 설계, 수집 과정, 도메인 경험을 근거로 판단한다.
유형에 따라 처리가 달라지는 이유
"결측이 있는 행을 지운다"는 같은 행동이 유형에 따라 전혀 다른 결과를 낳는다.
age가 비어서 지우면 빠지는 유저가 전체와 비슷한 사람들이다. 표본이 조금 줄 뿐 데이터의 성격은 그대로다.
last_login_date가 비어서 지우면 이탈 유저가 대거 빠진다. 남은 데이터는 잔존 유저 위주가 되어, 이탈률을 분석하려던 목적이 무너진다. 대신
churn_flag로 나눠 다루면 이 문제를 피할 수 있다.review_score가 비어서 지우면 불만족한 유저가 빠진다. 평점 평균이 3.17에서 3.44로 올라간다. 관측된 평균(3.44)으로 채워도 결과는 같다. 어느 쪽도 편향을 없애지 못한다.
정리하면 MCAR은 삭제해도 되고, MAR은 채우는 편이 낫고, MNAR은 어느 쪽도 답이 아니다.
결측값 삭제
결측이 있는 행이나 열을 제거하는 방법이다. 값을 새로 만들어 내지 않으므로 가장 단순하고 왜곡의 소지가 적다.
행 삭제 (목록별 삭제)
결측이 하나라도 있는 행을 통째로 지운다. 가장 널리 쓰이는 방식이고, 모든 열이 온전한 데이터만 남으므로 이후 분석이 단순해진다.
문제는 열이 많을수록 남는 행이 급격히 줄어든다는 점이다. 열마다 다른 행이 비어 있기 때문이다. 2단계에서 확인했듯 개별 열의 결측률이 낮아 보여도 행은 순식간에 사라진다.
삭제하기 전에 남는 행이 몇 개인지 반드시 먼저 센다. "결측률이 5%뿐이니 괜찮겠지"라고 판단했다가 데이터의 절반을 잃는 일이 흔하다.
쌍별 삭제
계산할 때마다 필요한 열만 보고, 그 열이 채워진 행을 쓴다. 상관계수를 구할 때 A와 B의 상관은 두 열이 모두 있는 행으로, A와 C의 상관은 또 다른 행 집합으로 계산하는 식이다.
데이터를 최대한 활용한다는 장점이 있지만, 계산마다 표본이 달라진다. 상관행렬 전체가 서로 다른 사람들로 만들어져 일관성이 깨질 수 있다.
열 삭제
결측이 지나치게 많은 열은 변수 자체를 버린다. 절반 이상이 비어 있다면 무엇으로 채우든 대부분이 추정값이 되므로 그 열을 쓰는 의미가 약해진다.
다만 결측이 많다는 사실 자체가 정보일 수 있다. 값은 몰라도 응답 여부는 알 수 있고, 그것만으로 의미 있는 신호가 되는 경우가 많다.
설문에 "해본 로그라이크 게임을 적어주세요"라는 자유 응답 항목이 있다고 하자. 80%가 비어 있어서 열을 통째로 버리려는 참이다. 그런데 이 빈칸의 정체를 생각해 보면 이렇다.
응답 | 실제 의미 |
|---|---|
"하데스, 슬레이 더 스파이어" | 로그라이크 경험 있음 |
"아이작" | 로그라이크 경험 있음 |
(빈칸) | 안 해봤을 가능성이 높음 |
안 해본 사람은 적을 게 없으니 그냥 넘긴다. 빈칸이 곧 "경험 없음"이라는 답인 셈이다. 열을 지우면 이 정보까지 사라지지만, 0과 1로 바꾸면 그대로 남는다.
# roguelike_games는 예시용 열이다. 위 예제 CSV에는 들어 있지 않다.
# 자유 응답 원문은 버리고, 응답 여부만 0과 1로 남긴다
df["played_roguelike"] = df["roguelike_games"].notna().astype(int)
df = df.drop(columns=["roguelike_games"])
게임 제목을 일일이 분류하는 수고 없이 "로그라이크 경험자"라는 변수 하나를 얻는다. 이탈 예측이나 장르 추천에 쓸 수 있는 신호다.
다만 빈칸이 정말 "안 해봤다"인지, 귀찮아서 안 쓴 것인지는 구분되지 않는다. 그래서 이 변수는 "경험 없음"이 아니라 "응답하지 않음"으로 읽는 편이 정확하다. 필수 응답 항목이었다면 해석이 더 분명해진다.
삭제해도 되는 조건
결측이 MCAR에 가깝다. 특정 집단에 몰려 있지 않다.
결측 비율이 낮다. 흔히 5% 안팎을 기준으로 삼지만 절대적인 값은 아니다.
삭제 후에도 분석에 충분한 양이 남는다.
삭제 전후로 주요 변수의 평균과 분포가 크게 달라지지 않는다.
삭제 전후를 비교하는 습관이 중요하다. 지우기 전 평균과 지운 뒤 평균이 눈에 띄게 다르다면 그 결측은 MCAR이 아니다. 삭제가 데이터의 성격을 바꾸고 있다는 신호다.
결측값 대치
빈자리를 다른 값으로 채우는 방법이다. 행을 보존하므로 표본이 줄지 않는다. 대신 채운 값은 측정값이 아니라 추정값이라는 점을 잊으면 안 된다.
대표값 대치
평균, 중앙값, 최빈값처럼 하나의 대표값으로 모든 빈자리를 채운다. 가장 간단한 방법이다.
대표값 | 쓰는 경우 | 주의 |
|---|---|---|
평균 | 분포가 좌우 대칭인 수치형 | 이상치에 크게 흔들린다 |
중앙값 | 한쪽으로 치우친 수치형 | 대체로 평균보다 안전하다 |
최빈값 | 범주형 | 특정 범주가 과도하게 늘어난다 |
이상치가 섞여 있으면 평균은 쉽게 흔들린다. 이 데이터의 age에는 999세나 음수 같은 입력 오류가 들어 있어서 평균이 37.6인 반면 중앙값은 36.0이다. 오류를 걸러내지 않은 채 평균으로 채우면 그 오류가 빈칸에까지 번진다.
total_purchase_krw처럼 소수의 큰 값이 꼬리를 만드는 변수도 마찬가지다. 결제액이 1,000만 원을 넘는 고래 유저가 섞여 있어 평균이 그쪽으로 끌려간다.
대표값 대치의 근본적인 한계는 모든 빈자리에 같은 값이 들어간다는 것이다. 값이 한곳에 몰리면서 분산이 실제보다 작아지고, 다른 변수와의 관계도 흐려진다. 결측이 많을수록 이 왜곡이 커진다.
그룹별 대치
전체 하나의 대표값 대신, 의미 있는 집단으로 나눠 각 집단의 대표값으로 채운다.
이 데이터에서 플레이타임 중앙값은 잔존 유저 216시간, 이탈 유저 109.8시간으로 2배 가까이 차이 난다. 전체 중앙값 하나로 채우면 잔존 유저는 낮게, 이탈 유저는 높게 잡힌다. churn_flag로 나눠 채우면 이 왜곡이 줄어든다.
# 전체 중앙값 대신 그룹별 중앙값으로 채운다
group_median = df.groupby("churn_flag")["total_playtime_hours"].transform("median")
df["total_playtime_hours"] = df["total_playtime_hours"].fillna(group_median)
MAR에 특히 잘 맞는다. 결측을 설명하는 변수가 데이터 안에 있으니, 그 변수로 그룹을 나누면 훨씬 그럴듯한 값을 넣을 수 있다. 구현 난이도는 대표값 대치와 거의 같으면서 효과는 뚜렷하다.
그룹을 너무 잘게 나누면 각 그룹의 표본이 적어져 대표값이 불안정해진다. 그룹당 최소 몇십 개는 남도록 나누고, 표본이 부족한 그룹은 상위 그룹의 값을 쓴다.
예측 대치
결측이 없는 다른 열들로 모델을 만들어 빈 값을 예측한다. 회귀, KNN, 랜덤포레스트 등을 쓴다. 사람마다 다른 값이 들어가므로 대표값 대치보다 변수 간 관계를 잘 보존한다.
KNN 대치: 비슷한 특성을 가진 이웃 몇 명의 값을 평균 낸다. 직관적이고 구현이 쉽다.
회귀 대치: 다른 변수로 회귀식을 세워 예측한다. 예측값을 그대로 쓰면 분산이 줄어들므로 잔차를 더하는 보정을 검토한다.
다중 대치: 서로 다른 대치본을 여러 개 만들어 각각 분석한 뒤 결과를 합친다. "채운 값에는 불확실성이 있다"는 사실을 결과에 반영할 수 있다.
정교하지만 비용이 든다. 모델이 틀리면 그럴듯해 보이는 오답이 들어가고, 그 값이 실제 측정값처럼 취급되어 다음 분석으로 흘러간다. 대표값 대치의 오류는 눈에 띄지만 예측 대치의 오류는 잘 보이지 않는다.
결측 표시 변수 남기기
어떤 방법으로 채우든, "이 자리는 원래 비어 있었다"를 0과 1로 기록한 열을 함께 두는 것을 권한다.
df["review_missing"] = df["review_score"].isna().astype(int)
df["review_score"] = df["review_score"].fillna(df["review_score"].median())
채운 값이 분석에 얼마나 영향을 주는지 나중에 확인할 수 있고, MNAR이 의심될 때는 결측 여부 자체가 예측에 도움이 되는 변수가 되기도 한다. 리뷰를 쓰지 않았다는 사실이 이미 불만족의 신호라면 그 정보를 버릴 이유가 없다.
대치할 때 반드시 지킬 것
대치 기준은 학습 데이터에서만 만든다. 전체 데이터의 중앙값으로 채운 뒤 학습·검증을 나누면, 검증 데이터의 정보가 학습에 새어 든다. 먼저 나누고, 학습 데이터에서 구한 중앙값을 검증·테스트에도 그대로 적용한다.
from sklearn.model_selection import train_test_split

train, test = train_test_split(df, test_size=0.2, random_state=42)

fill_value = train["age"].median()      # 기준은 학습 데이터에서만 만든다
train["age"] = train["age"].fillna(fill_value)
test["age"] = test["age"].fillna(fill_value)   # 같은 값을 테스트에도 적용
이것을 데이터 누수(data leakage)라고 한다. 검증 점수는 좋아 보이는데 실제 서비스에서 성능이 떨어지는 흔한 원인이다. 결측 대치는 누수가 발생하기 가장 쉬운 지점 중 하나다.
삭제와 대치, 무엇을 고를까
상황 | 권장 | 이유 |
|---|---|---|
결측 5% 미만, MCAR | 행 삭제 | 잃는 정보가 적고 왜곡이 없다 |
결측이 많지만 MCAR | 대표값 대치 | 표본을 지키는 편이 이득이다 |
MAR | 그룹별 대치 또는 예측 대치 | 설명 변수가 있으니 활용한다 |
MNAR | 결측 표시 변수 + 한계 명시 | 삭제·대치 모두 편향을 남긴다 |
결측률 50% 이상 | 열 삭제 검토 | 대부분이 추정값이 된다 |
표에 없는 상황이라면 원칙은 하나다. 여러 방법을 적용해 보고 결과가 얼마나 달라지는지 비교한다. 방법을 바꿔도 결론이 같다면 어느 쪽을 써도 무방하고, 결론이 뒤집힌다면 그 분석은 결측 처리에 크게 의존하고 있다는 뜻이므로 신중해야 한다.
실무 점검 순서
열별 결측 비율을 센다. 전체 하나만 보지 말고 열마다 확인한다.
삭제 비용을 먼저 계산한다. 행 삭제 시 몇 개가 남는지 세어 본다.
함께 비는 열을 찾는다. 결측 상관이 높은 열은 함께 처리한다.
집단을 나눠 결측률을 비교한다. 특정 집단에 몰려 있으면 MAR을 의심한다.
수집 과정을 확인한다. 장비 문제인지, 응답 거부인지에 따라 유형이 갈린다.
방법을 정하고 기록한다. 왜 그 방법을 골랐는지와 결측 표시 변수를 함께 남긴다.
결측치 처리는 빈칸을 없애는 기술이 아니라, 어떤 정보를 보존하고 어떤 가정을 받아들일지 정하는 과정이다. 표를 깔끔하게 만드는 순간 사라지는 신호가 있다는 점을 기억한다.
예제 데이터에 대하여
1~3단계에 쓴 데이터는 학습용으로 직접 만든 가상 데이터다. 실제 게임사 기록이 아니다. 결측 세 유형과 이상치를 의도적으로 심어 두었다.
파일 | 행 | 내용 |
|---|---|---|
| 4,030 | 결측·이상치·중복이 있는 원본 |
| 4,000 | 결측이 없는 정답지 |
생성 스크립트는 시드가 고정되어 있어 몇 번을 실행해도 같은 파일이 나온다. 열 설명과 심어 둔 패턴은 데이터 설명 문서에 정리되어 있다.
댓글 0
댓글을 불러오는 중…