스케일링은 값의 크기 단위를 맞추는 전처리다. 키 170cm와 연봉 5,000만원을 그대로 한 모델에 넣으면, 모델은 연봉 쪽 숫자가 크다는 이유만으로 그 열을 더 중요하게 취급한다. 스케일링은 이 불공정을 없앤다.
이 글은 게임 유저 4,030명의 실제 CSV 한 개를 끝까지 따라가며 StandardScaler, MinMaxScaler, RobustScaler, Normalizer 네 가지를 하나씩 적용해 본다. 모든 코드와 출력은 실제로 실행한 결과다.
이 데이터에는 결제액 300만~1,200만원인 고래 유저 12명이 일부러 섞여 있다. 이 12명 때문에 네 스케일러의 결과가 완전히 달라진다. 그 차이를 보는 것이 이 글의 핵심이다.
예제 데이터 준비
데이터는 이 사이트에 공개되어 있다. 아래 코드를 그대로 실행하면 내려받지 않고 바로 읽을 수 있다.
import pandas as pd
from urllib.request import Request, urlopen

URL = "https://1000page.pages.dev/data/game-users.csv"
request = Request(URL, headers={"User-Agent": "Mozilla/5.0"})
with urlopen(request, timeout=30) as response:
    df = pd.read_csv(response)

print(df.shape)
(4030, 14)스케일링에 쓸 수치 열 세 개만 남긴다. 나이가 999세이거나 플레이타임이 음수인 입력 오류는 걷어내되, 고래 유저 같은 진짜 극단값은 그대로 둔다. 그래야 스케일러별 차이가 드러난다.
# 입력 오류만 걷어낸다. 고래·봇 같은 진짜 극단값은 남겨야 스케일러 차이가 보인다
df = df[df["age"].between(10, 90) & (df["total_playtime_hours"] >= 0)]
cols = ["age", "total_playtime_hours", "total_purchase_krw"]
X = df[cols]
print(X.shape)
(3812, 3)왜 스케일링이 필요한가
세 열의 크기를 먼저 확인한다.
print(X.agg(["min", "max", "mean", "std"]).round(1)) age total_playtime_hours total_purchase_krw
min 18.0 1.0 0.0
max 70.0 20434.1 11671314.0
mean 37.1 300.1 37509.6
std 8.3 926.7 524181.0spans = X.max() - X.min()
print(spans)
print("최대 / 최소 범위 배율:", round(spans.max() / spans.min()))age 52.0
total_playtime_hours 20433.1
total_purchase_krw 11671314.0
dtype: float64
최대 / 최소 범위 배율: 224448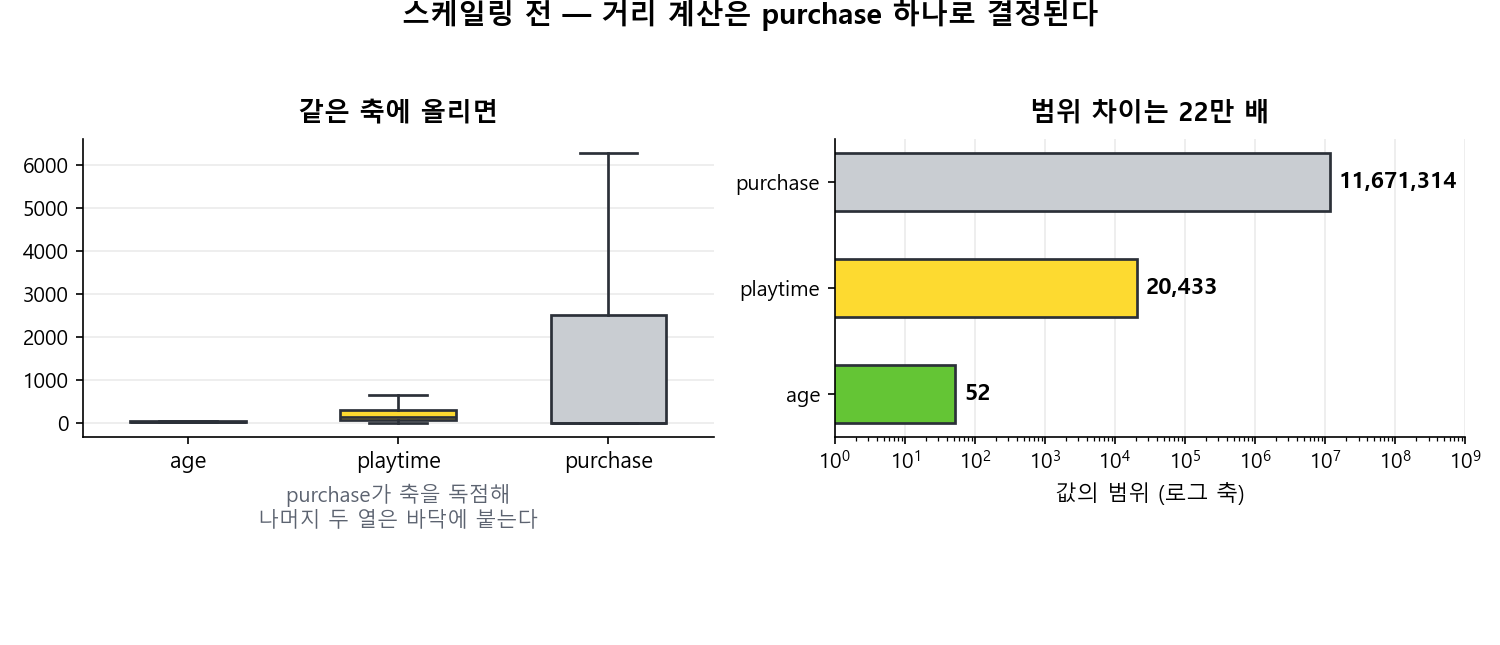
범위 차이가 22만 배다. 두 유저 사이의 거리를 계산하면 나이가 40살 차이 나도 결제액 100만원 차이에 완전히 묻힌다. 거리를 쓰는 모델에서는 사실상 total_purchase_krw 하나만 보는 것과 같아진다.
스케일에 민감한 모델과 그렇지 않은 모델을 구분해 두면 판단이 쉬워진다.
구분 | 해당 모델 | 이유 |
|---|---|---|
민감함 (스케일링 필요) | k-NN, k-means, SVM, PCA | 특성 간 거리를 직접 계산한다 |
민감함 (스케일링 필요) | Ridge·Lasso, 로지스틱 회귀, 신경망 | 규제 항과 경사하강 수렴이 값 크기에 좌우된다 |
둔감함 | 결정트리, 랜덤포레스트, 그래디언트 부스팅 | 한 열 안의 크기 순서만 보고 분할점을 찾는다 |
1. StandardScaler — 평균 0, 표준편차 1
각 값에서 그 열의 평균을 빼고, 그 열의 표준편차로 나눈다. 결과의 중심은 0이 되고 흩어진 정도는 1이 된다.
import numpy as np
from sklearn.preprocessing import StandardScaler

np.set_printoptions(suppress=True)   # 지수 표기 대신 일반 숫자로 출력

scaler = StandardScaler()
Z = scaler.fit_transform(X)

print("빼는 값(평균)      :", scaler.mean_.round(2))
print("나누는 값(표준편차) :", scaler.scale_.round(2))
print("변환 후 평균       :", Z.mean(axis=0).round(6))
print("변환 후 표준편차    :", Z.std(axis=0).round(6))
빼는 값(평균) : [ 37.15 300.13 37509.63]
나누는 값(표준편차) : [ 8.31 926.62 524112.26]
변환 후 평균 : [0. 0. 0.]
변환 후 표준편차 : [1. 1. 1.]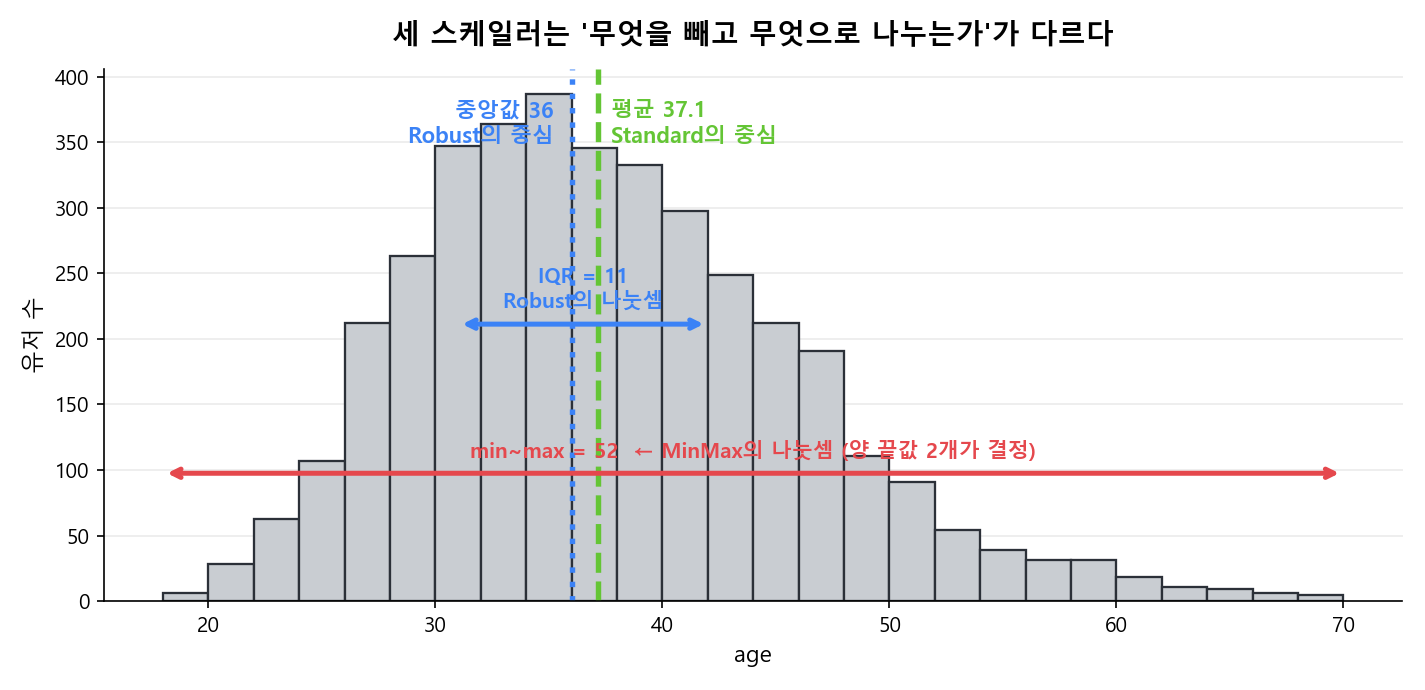
변환 후 평균이 정확히 0, 표준편차가 정확히 1이 되었다. 값의 범위는 고정되지 않아서 이상치는 그대로 큰 값으로 남는다.
import pandas as pd
Zs = pd.DataFrame(Z, columns=cols)
print(Zs.describe(percentiles=[0.25, 0.5, 0.75, 0.99]).round(3))
age total_playtime_hours total_purchase_krw
count 3812.000 3812.000 3812.000
mean 0.000 0.000 0.000
std 1.000 1.000 1.000
min -2.305 -0.323 -0.072
25% -0.740 -0.255 -0.072
50% -0.138 -0.168 -0.072
75% 0.584 0.004 -0.067
99% 2.750 1.630 0.257
max 3.954 21.728 22.197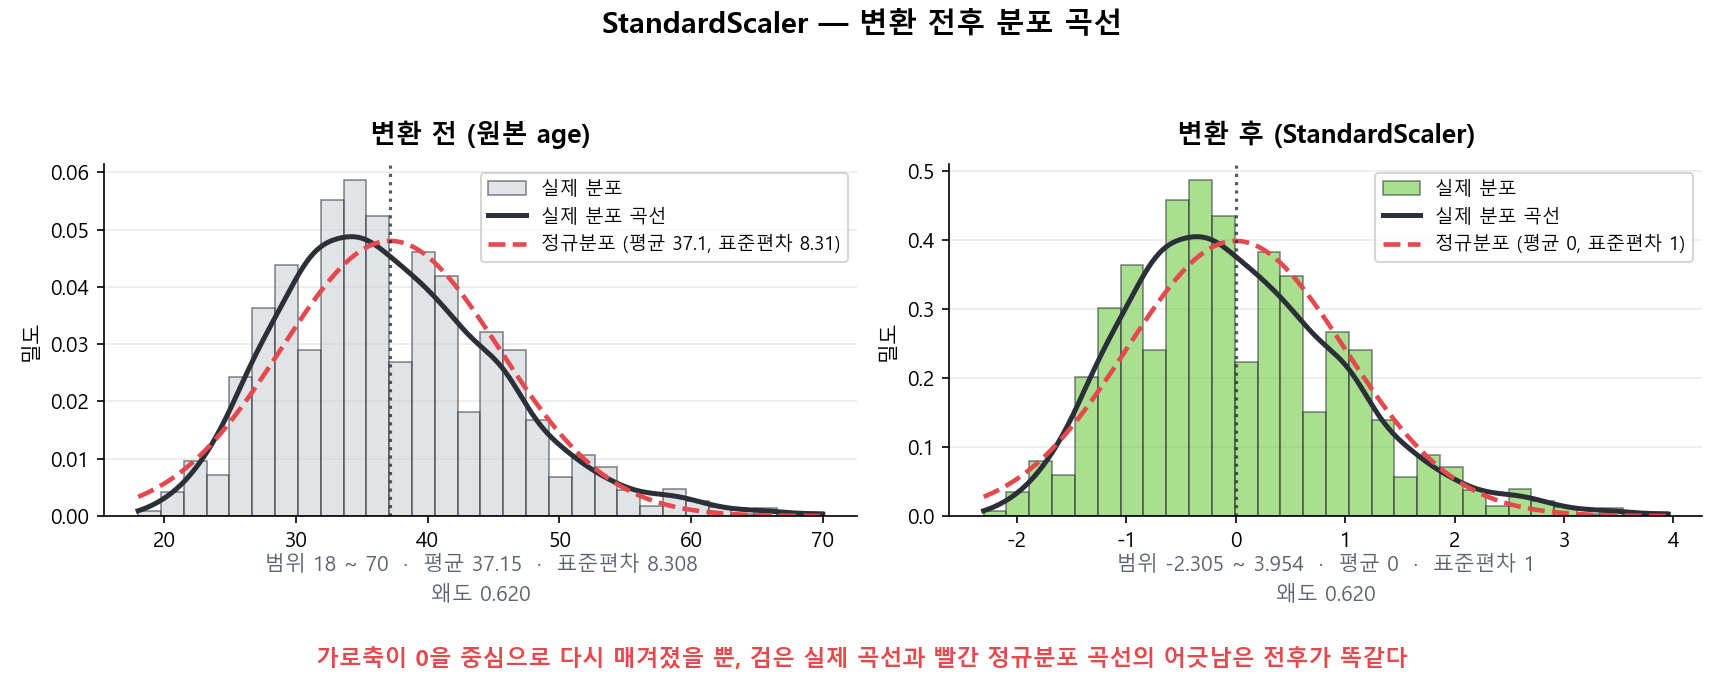
age는 -2.3 ~ 4.0으로 얌전하지만 total_purchase_krw의 최댓값은 22.2까지 올라간다. 이상치가 있으면 그 이상치가 평균과 표준편차 자체를 밀어버린다는 점이 StandardScaler의 약점이다.
위 그림에서 빨간 점선은 같은 평균·표준편차를 가진 정규분포를 그린 기준선이다. 변환 후 그 기준선이 평균 0, 표준편차 1짜리로 바뀌었을 뿐, 검은 실제 곡선이 빨간 기준선에서 벗어난 정도는 전후가 똑같다. 오른쪽으로 살짝 꼬리가 끌리는 모양이 그대로 남아 있다.
이름에 standard가 들어가지만 정규분포로 만들어 주지는 않는다. 이 글 뒤쪽에서 왜도(치우침) 수치로 직접 확인한다.
2. MinMaxScaler — 0과 1 사이로
각 값에서 그 열의 최솟값을 빼고, 최댓값과 최솟값의 차이로 나눈다. 최솟값은 0, 최댓값은 1이 된다.
from sklearn.preprocessing import MinMaxScaler

mm = MinMaxScaler()
Zm = pd.DataFrame(mm.fit_transform(X), columns=cols)

print("빼는 값(최솟값)      :", mm.data_min_.round(1))
print("나누는 값(최대-최소) :", (mm.data_max_ - mm.data_min_).round(1))
print()
print(Zm.describe(percentiles=[0.5, 0.99]).round(4))
빼는 값(최솟값) : [18. 1. 0.]
나누는 값(최대-최소) : [ 52. 20433.1 11671314. ]
age total_playtime_hours total_purchase_krw
count 3812.0000 3812.0000 3812.0000
mean 0.3683 0.0146 0.0032
std 0.1598 0.0454 0.0449
min 0.0000 0.0000 0.0000
50% 0.3462 0.0070 0.0000
99% 0.8077 0.0886 0.0147
max 1.0000 1.0000 1.0000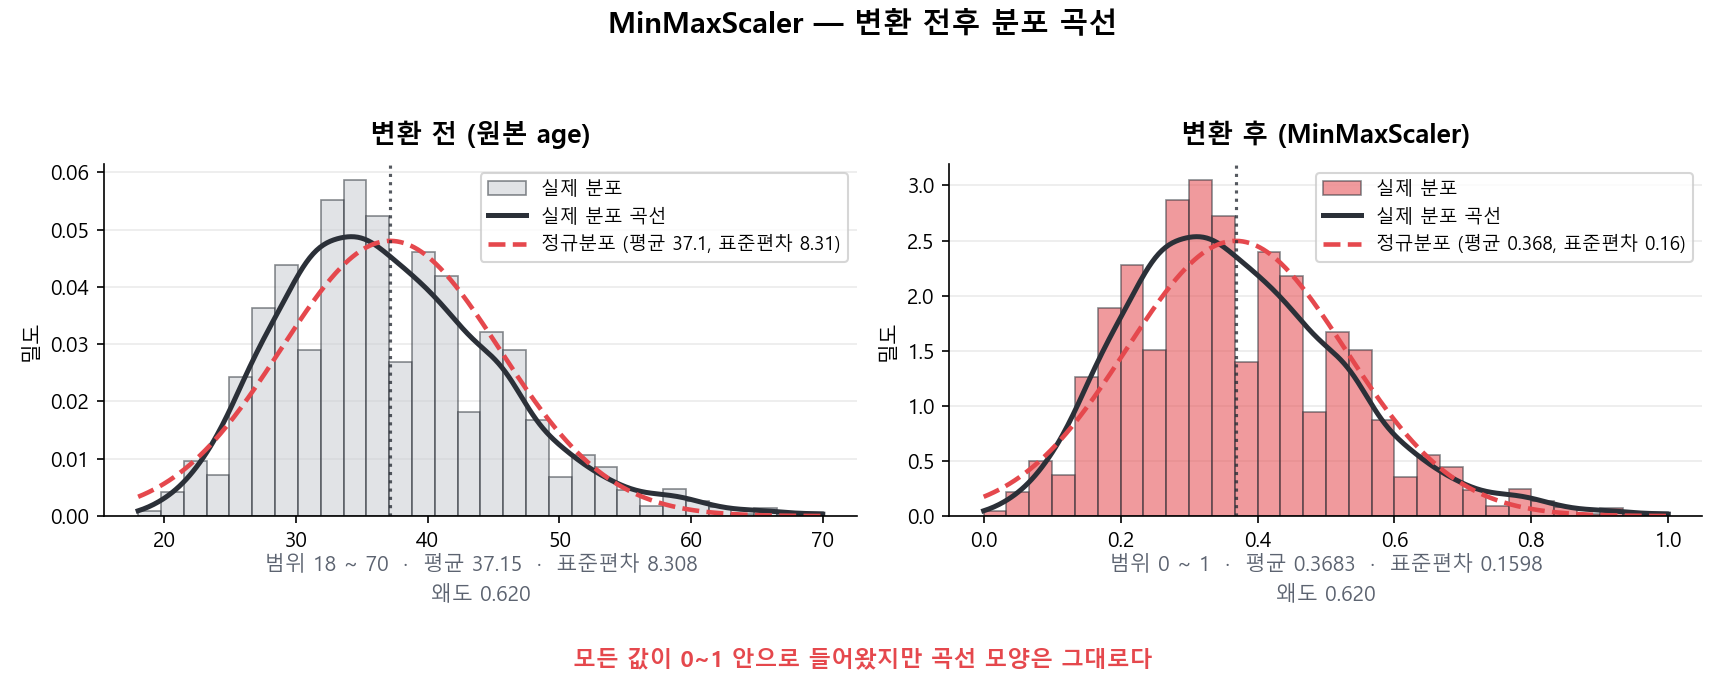
가로축이 정확히 0에서 1 사이로 들어왔다. 다만 age처럼 극단값이 없는 열에서나 이렇게 고르게 퍼진다. 곡선 모양과 왜도(0.620)는 변환 전과 같다.
여기서 문제가 드러난다. total_purchase_krw의 중앙값이 0.0000, 99% 지점조차 0.0147이다. 나눗셈의 분모가 고래 유저 한 명의 결제액 1,167만원이기 때문이다.
whale = X["total_purchase_krw"] >= 1_000_000
normal = ~whale.values
print("고래 유저 수:", int(whale.sum()), "/", len(X))
print("일반 유저가 차지하는 구간:",
      round(Zm.loc[normal, "total_purchase_krw"].min(), 4),
      "~", round(Zm.loc[normal, "total_purchase_krw"].max(), 4))
print("0.05 이하 비율:", round((Zm["total_purchase_krw"] <= 0.05).mean(), 4))
고래 유저 수: 12 / 3812
일반 유저가 차지하는 구간: 0.0 ~ 0.0441
0.05 이하 비율: 0.9969전체의 0.3%인 고래 12명이 0~1 구간을 거의 독점한다. 나머지 99.7%는 0 ~ 0.044라는 좁은 구간에 뭉개져서, 모델 입장에서는 무과금 유저와 50만원 결제 유저가 사실상 같은 값이 된다.
3. RobustScaler — 중앙값과 IQR 사용
각 값에서 중앙값을 빼고 IQR로 나눈다. IQR은 75% 지점에서 25% 지점을 뺀 값으로, 양 끝의 극단값을 아예 계산에 넣지 않는다.
from sklearn.preprocessing import RobustScaler

rb = RobustScaler()
Zr = pd.DataFrame(rb.fit_transform(X), columns=cols)

print("빼는 값(중앙값):", rb.center_.round(1))
print("나누는 값(IQR):", rb.scale_.round(1))
print()
print(Zr.describe(percentiles=[0.25, 0.5, 0.75]).round(3))
빼는 값(중앙값): [ 36. 144.6 0. ]
나누는 값(IQR): [ 11. 239.9 2525. ]
age total_playtime_hours total_purchase_krw
count 3812.000 3812.000 3812.000
mean 0.105 0.648 14.855
std 0.755 3.863 207.596
min -1.636 -0.599 0.000
25% -0.455 -0.335 0.000
50% 0.000 0.000 0.000
75% 0.545 0.665 1.000
max 3.091 84.575 4622.303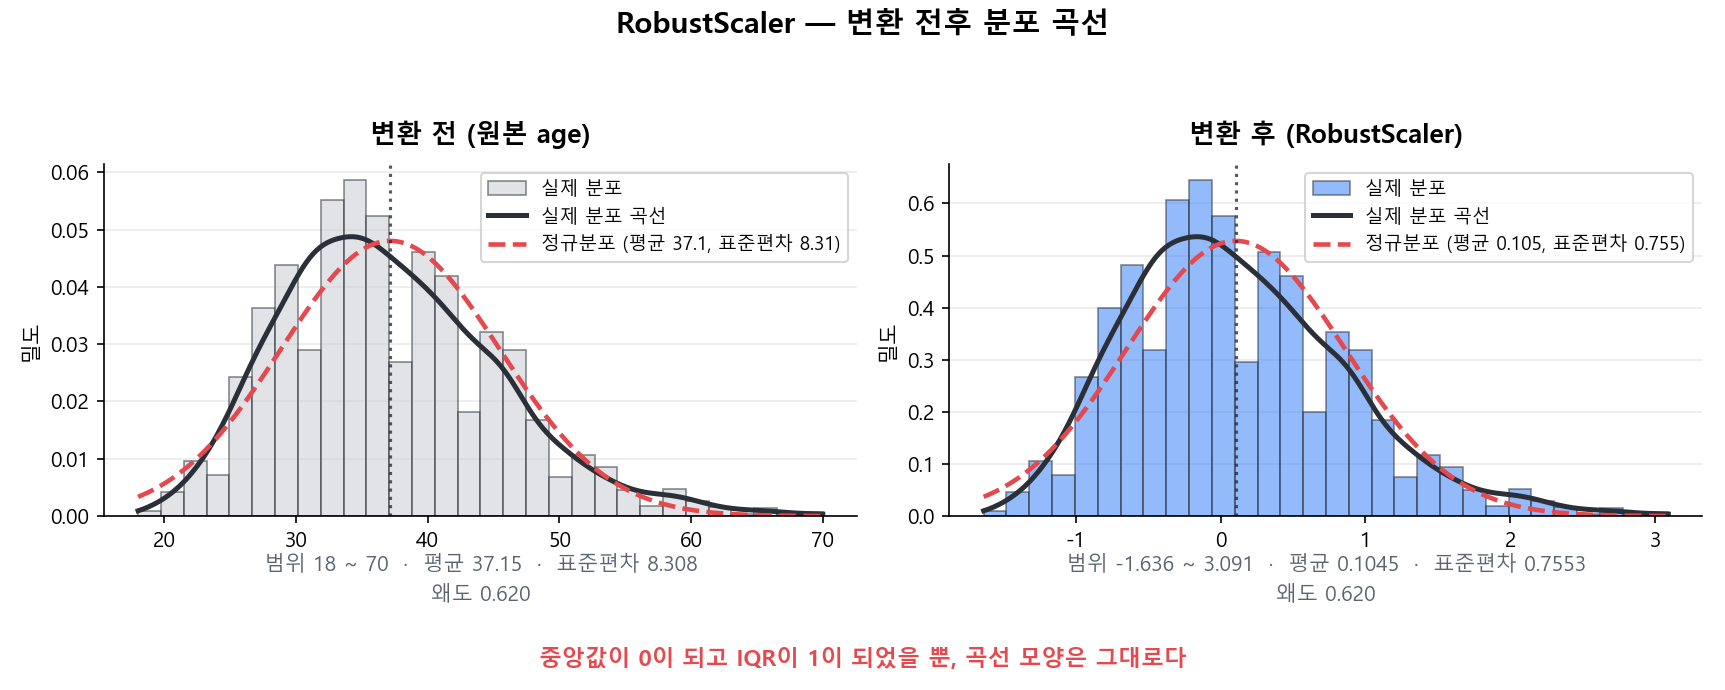
25% 지점이 -0.455, 75% 지점이 0.545로 두 값의 차이가 정확히 1이다. IQR로 나눴기 때문이다. 여기서도 곡선 모양은 변환 전과 같다.
나눗셈의 분모가 1,167만원이 아니라 IQR인 2525원이다. 덕분에 일반 유저 구간이 넓게 펼쳐진다. 다만 이상치를 제거하는 것이 아니라 기준만 바꾸는 것이므로, 고래는 여전히 4622라는 큰 값으로 남는다.
같은 유저 세 명을 세 스케일러로 각각 변환해 비교하면 차이가 분명해진다.
picks = pd.DataFrame({"total_purchase_krw": [0, 17150, 514900]})
row = X[["total_purchase_krw"]]
compare = pd.DataFrame({
    "원본(원)": picks["total_purchase_krw"],
    "Standard": StandardScaler().fit(row).transform(picks).ravel(),
    "MinMax": MinMaxScaler().fit(row).transform(picks).ravel(),
    "Robust": RobustScaler().fit(row).transform(picks).ravel(),
})
print(compare.round(4).to_string(index=False))
원본(원) Standard MinMax Robust
0 -0.0716 0.0000 0.0000
17150 -0.0388 0.0015 6.7921
514900 0.9109 0.0441 203.9208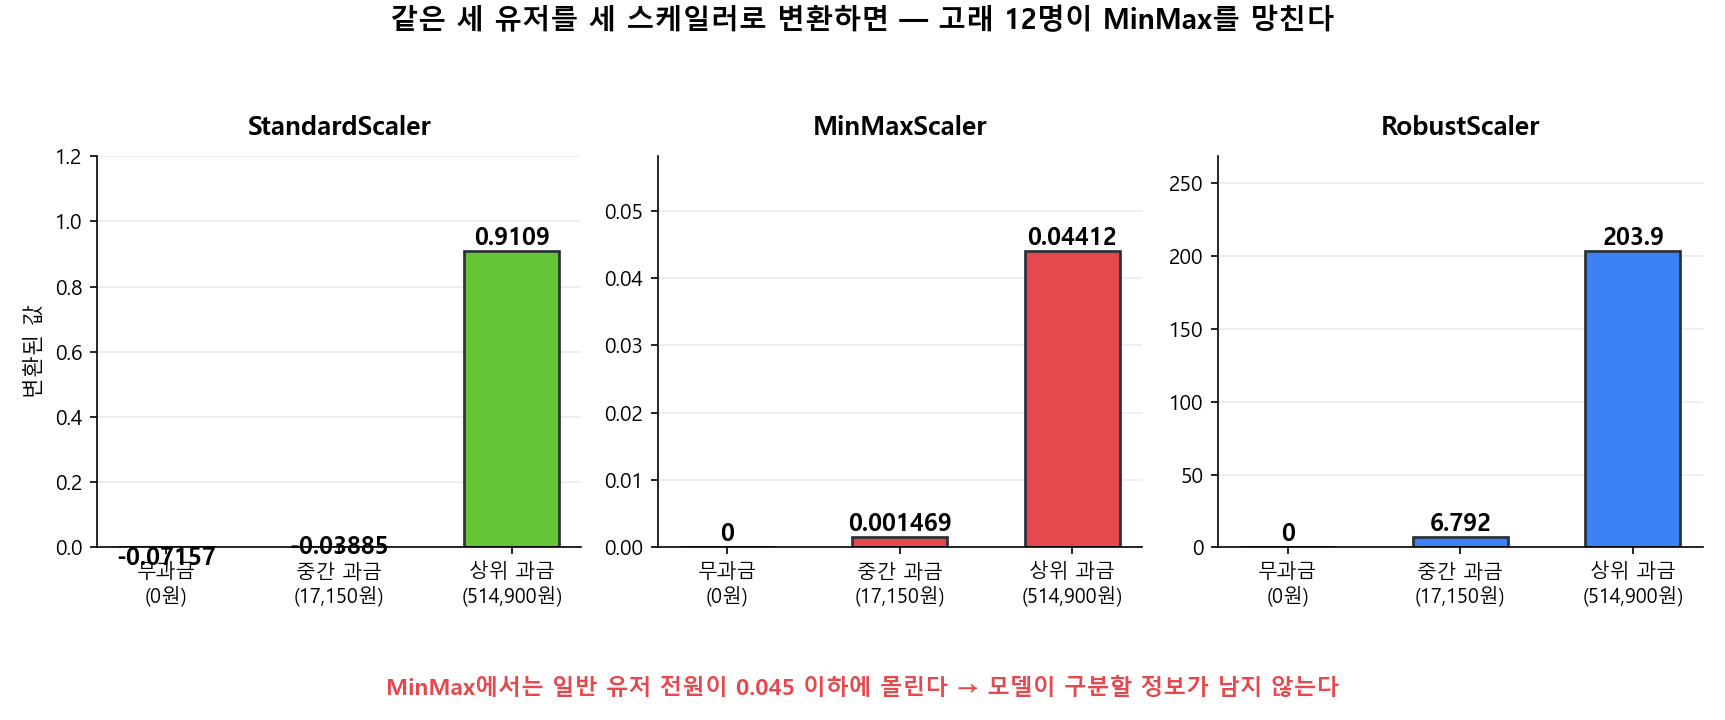
무과금과 17,150원 결제 유저의 차이를 보자. MinMax에서는 0.0015 차이뿐이지만 Robust에서는 6.79 차이가 난다. Robust는 일반 유저 사이의 차이를 살려낸다.
4. Normalizer — 유일하게 축이 다르다
Normalizer는 앞의 세 가지와 근본적으로 다르다. 앞의 셋은 열(세로)마다 통계를 계산하지만, Normalizer는 행(가로) 하나씩 처리해 그 행의 길이를 1로 만든다. 열끼리 크기를 맞추는 도구가 아니다.
import numpy as np
from sklearn.preprocessing import Normalizer

nz = Normalizer()
Zn = pd.DataFrame(nz.fit_transform(X), columns=cols)

print("원본 첫 3행")
print(X.head(3).to_string(index=False))
print()
print("Normalizer 적용 후")
print(Zn.head(3).round(4).to_string(index=False))
print()
print("각 행의 길이(노름):", np.round(np.linalg.norm(Zn.values, axis=1)[:3], 4))
원본 첫 3행
age total_playtime_hours total_purchase_krw
31.0 459.3 21900
38.0 294.4 0
40.0 101.7 0
Normalizer 적용 후
age total_playtime_hours total_purchase_krw
0.0014 0.0210 0.9998
0.1280 0.9918 0.0000
0.3660 0.9306 0.0000
각 행의 길이(노름): [1. 1. 1.]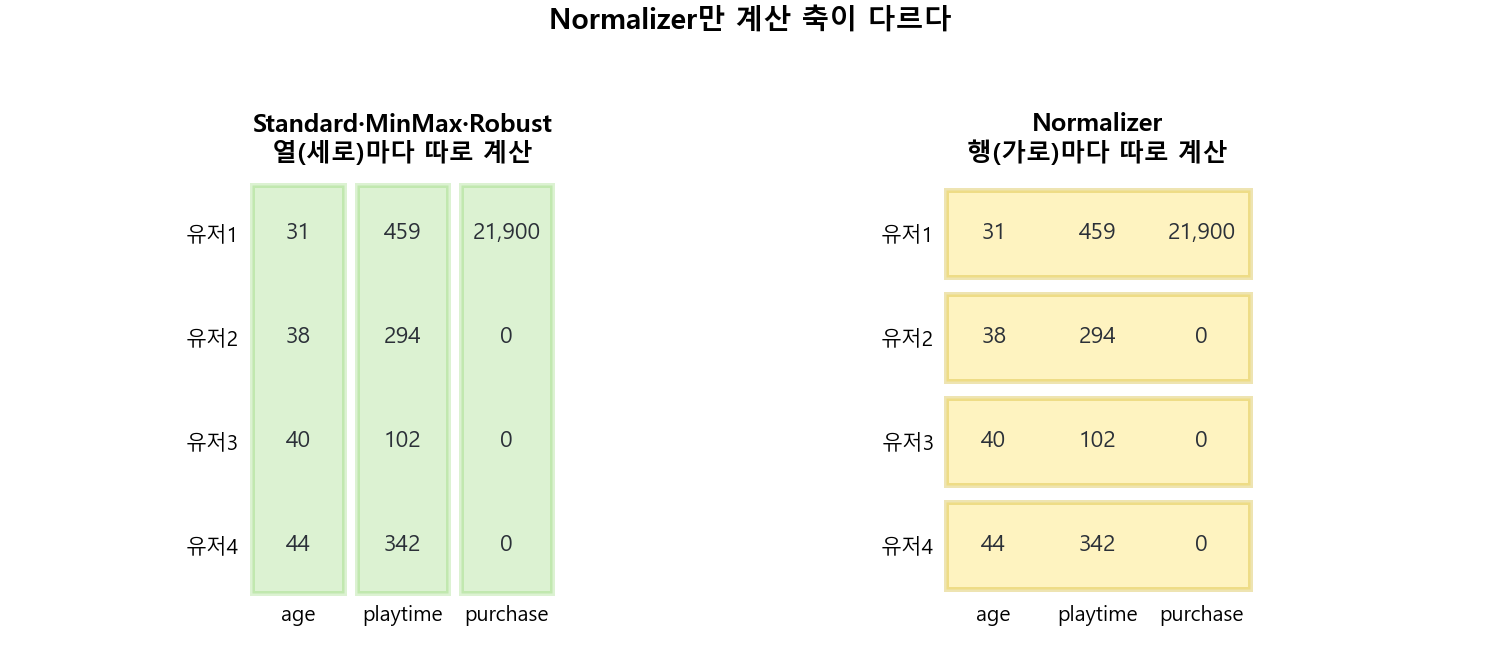
모든 행의 길이가 1이 되었다. 그 대가로 크기 정보가 사라진다.
from sklearn.preprocessing import Normalizer
import numpy as np

two = np.array([[30.0, 100.0, 0.0],
                [30.0, 1000.0, 0.0]])
print(np.round(Normalizer().fit_transform(two), 4))
print()
same_ratio = np.array([[3.0, 10.0, 0.0],
                       [30.0, 100.0, 0.0]])
print(np.round(Normalizer().fit_transform(same_ratio), 4))
[[0.2873 0.9578 0. ]
[0.03 0.9996 0. ]]
[[0.2873 0.9578 0. ]
[0.2873 0.9578 0. ]]아래쪽 결과를 보자. 플레이타임 10시간인 유저와 100시간인 유저가 완전히 같은 값이 되었다. 비율만 같으면 크기가 10배 달라도 구분되지 않는다.
그래서 Normalizer는 보통 스케일링 후보가 아니다. 문서의 단어 빈도 벡터나 코사인 유사도처럼 방향만 중요하고 크기는 무시해야 하는 경우에 쓴다. 열 단위로 크기를 맞추고 싶다면 앞의 세 가지 중에서 고른다.
스케일링 전후 비교 — 무엇이 바뀌고 무엇이 그대로인가
여기까지 세 스케일러를 각각 봤으니, 이제 같은 열 하나를 네 가지 상태로 나란히 놓고 비교한다. age 열을 골랐다. 원본이 종 모양에 가까워서 변화를 눈으로 확인하기 좋다.
from scipy.stats import skew
from sklearn.preprocessing import MinMaxScaler, RobustScaler, StandardScaler

one = X[["age"]]                      # 열 하나만 놓고 전후를 비교한다
results = {
    "스케일링 전": one["age"].values,
    "Standard": StandardScaler().fit_transform(one).ravel(),
    "MinMax": MinMaxScaler().fit_transform(one).ravel(),
    "Robust": RobustScaler().fit_transform(one).ravel(),
}

summary = pd.DataFrame({
    name: {
        "최솟값": v.min(),
        "최댓값": v.max(),
        "평균": v.mean(),
        "표준편차": v.std(),
        "왜도(분포 모양)": skew(v),
    }
    for name, v in results.items()
}).T
print(summary.round(3).to_string())
최솟값 최댓값 평균 표준편차 왜도(분포 모양)
스케일링 전 18.000 70.000 37.150 8.308 0.62
Standard -2.305 3.954 0.000 1.000 0.62
MinMax 0.000 1.000 0.368 0.160 0.62
Robust -1.636 3.091 0.105 0.755 0.62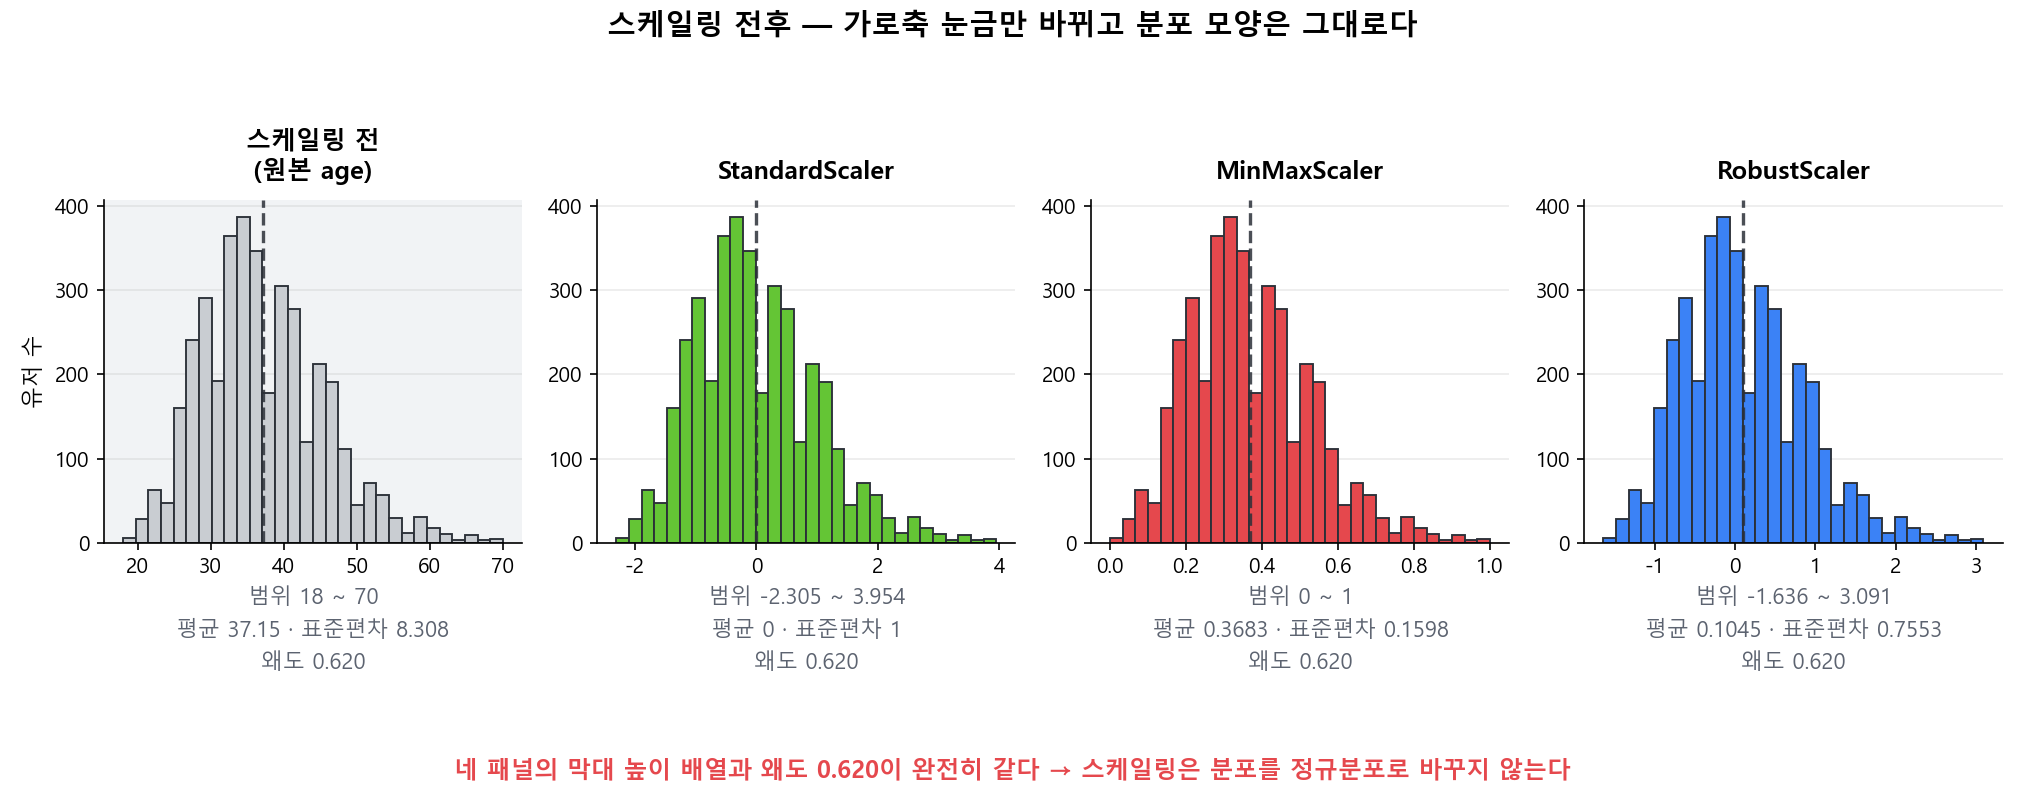
표의 앞 네 칸과 마지막 칸을 나눠서 읽는 것이 핵심이다.
구분 | 스케일링 전 | Standard | MinMax | Robust | 결론 |
|---|---|---|---|---|---|
범위 (바뀜) | 18 ~ 70 | -2.305 ~ 3.954 | 0 ~ 1 | -1.636 ~ 3.091 | 눈금이 다시 매겨진다 |
평균 (바뀜) | 37.15 | 0 | 0.368 | 0.105 | 중심이 옮겨진다 |
표준편차 (바뀜) | 8.308 | 1 | 0.160 | 0.755 | 폭이 다시 정해진다 |
왜도 (그대로) |
|
|
|
| 분포 모양은 손대지 않는다 |
범위·평균·표준편차는 모두 달라졌는데 왜도만 소수점 두 자리까지 네 값이 완전히 같다. 왜도는 분포가 한쪽으로 치우친 정도를 나타내는 값이므로, 이 숫자가 그대로라는 것은 분포의 모양 자체가 전혀 변하지 않았다는 뜻이다.
위 그림에서도 네 히스토그램의 막대 높이 배열이 완전히 같다. 달라진 것은 가로축에 적힌 숫자뿐이다. 세 스케일러 모두 '빼고 나누는' 선형 변환이라서, 자를 cm에서 inch로 바꾼 것과 같다. 물건의 모양은 그대로다.
그래서 '정규화(normalization)'라는 말이 '정규분포로 만든다'는 뜻은 아니다. 치우친 분포를 실제로 펴려면 로그 변환이나 제곱근 변환 같은 비선형 변환이 따로 필요하다. 스케일링과 분포 변환은 별개의 작업이다.
참고로 앞서 다룬 세 열 전체에 대해 왜도를 확인해도 결과는 같다.
import numpy as np
from scipy.stats import skew

for name, data in [("원본", X.values), ("Standard", Z),
                   ("MinMax", Zm.values), ("Robust", Zr.values)]:
    print(f"{name:9s}", np.round(skew(data, axis=0), 3))
원본 [ 0.62 15.643 18.91 ]
Standard [ 0.62 15.643 18.91 ]
MinMax [ 0.62 15.643 18.91 ]
Robust [ 0.62 15.643 18.91 ]치우침이 심한 total_playtime_hours(15.6)와 total_purchase_krw(18.9)도 스케일링 후 값이 그대로다. 이런 열은 스케일링만으로 해결되지 않으므로 로그 변환을 먼저 검토해야 한다.
반드시 지킬 것: 학습 데이터로만 fit한다
스케일러의 기준값(평균·최솟값·중앙값)은 학습 데이터에서만 계산해야 한다. 전체 데이터에 fit_transform을 먼저 호출하면 테스트 데이터의 정보가 학습 과정에 새어 들어간다.
대상 | 올바른 호출 | 설명 |
|---|---|---|
학습 데이터 |
| 기준값을 계산하고 변환한다 |
테스트·실서비스 데이터 |
| 학습에서 얻은 기준값을 그대로 적용한다 |
테스트 데이터에 transform만 쓰면 학습 때 못 본 값이 범위를 벗어날 수 있다. MinMaxScaler에서 실제로 확인해 보자.
from sklearn.model_selection import train_test_split

X_train, X_test = train_test_split(X, test_size=0.25, random_state=42)
mm2 = MinMaxScaler().fit(X_train)
T = pd.DataFrame(mm2.transform(X_test), columns=cols)

print("테스트 변환값의 최댓값:", T.max().round(3).tolist())
print("[0, 1]을 벗어난 비율:")
print(((T < 0) | (T > 1)).mean().round(5))
테스트 변환값의 최댓값: [1.0, 1.041, 0.991]
[0, 1]을 벗어난 비율:
age 0.00105
total_playtime_hours 0.00105
total_purchase_krw 0.00000
dtype: float64total_playtime_hours의 최댓값이 1.041로 1을 넘었다. 학습 데이터에 없던 더 큰 값이 테스트에 있었다는 뜻이다. 이것은 버그가 아니라 정상 동작이다.
입력 범위를 반드시 0~1로 고정해야 한다면 clip=True를 쓴다.
mm3 = MinMaxScaler(clip=True).fit(X_train)
T2 = pd.DataFrame(mm3.transform(X_test), columns=cols)
print("clip=True 최댓값:", T2.max().round(3).tolist())
clip=True 최댓값: [1.0, 1.0, 0.991]
clip=True는 범위를 잘라 주지만 얼마나 벗어났는지에 대한 정보는 사라진다. 운영 환경에서는 범위 이탈 비율을 따로 기록해 두는 편이 안전하다.
Pipeline으로 누수를 원천 차단한다
직접 순서를 지키는 대신 Pipeline에 넣으면 교차검증의 각 폴드마다 스케일러가 알아서 학습 부분에만 fit된다. 네 스케일러를 한 번에 비교해 보자.
from sklearn.model_selection import cross_val_score
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import Normalizer

feat = ["age", "total_playtime_hours", "avg_session_min",
        "level", "total_purchase_krw"]
Xf = df[feat]
y = df["churn_flag"]

candidates = [
    ("스케일링 없음", "passthrough"),
    ("StandardScaler", StandardScaler()),
    ("MinMaxScaler", MinMaxScaler()),
    ("RobustScaler", RobustScaler()),
    ("Normalizer", Normalizer()),
]
for name, step in candidates:
    pipe = Pipeline([("scale", step), ("model", KNeighborsClassifier(n_neighbors=15))])
    score = cross_val_score(pipe, Xf, y, cv=5, scoring="accuracy").mean()
    print(f"{name:16s} {score:.4f}")
스케일링 없음 0.6180
StandardScaler 0.6081
MinMaxScaler 0.6036
RobustScaler 0.6230
Normalizer 0.6325이 데이터에서는 RobustScaler가 세 후보 중 가장 좋았고, MinMaxScaler가 가장 나빴다. 고래 12명 때문에 결제액 정보가 뭉개진 결과로 읽을 수 있다.
Normalizer 점수가 가장 높게 나왔지만 이것을 근거로 Normalizer를 고르면 안 된다. 행의 길이를 1로 만드는 과정에서 결제액 비중이라는 다른 정보가 우연히 이탈 예측에 맞아떨어진 것에 가깝다. 차이도 0.01 수준이라 이 한 번의 결과로 순위를 확정할 수 없다.
네 가지 비교
스케일러 | 빼는 값 | 나누는 값 | 결과 범위 | 이상치 영향 |
|---|---|---|---|---|
| 평균 | 표준편차 | 고정 안 됨 (평균 0, 표준편차 1) | 받음 |
| 최솟값 | 최대 - 최소 | 0 ~ 1 | 매우 크게 받음 (최악) |
| 중앙값 | IQR | 고정 안 됨 (중앙값 0) | 적게 받음 |
| 없음 | 행 벡터의 길이 | 행마다 길이 1 | 해당 없음 (축이 다름) |
계산 축과 용도는 다음과 같이 갈린다.
스케일러 | 계산 축 | 이럴 때 고른다 |
|---|---|---|
| 열(세로) | 기본값. 선형 모델·SVM·PCA·신경망의 출발점 |
| 열(세로) | 값 범위를 0~1로 고정해야 할 때(이미지 픽셀 등). 이상치를 먼저 처리한 뒤에만 |
| 열(세로) | 이상치가 있는데 지울 수 없을 때 |
| 행(가로) — 유일 | 행의 방향만 의미 있을 때(문서 벡터, 코사인 유사도) |
실무 선택 순서
모델이 거리·경사·규제를 쓰는지 확인한다. 트리 계열만 쓴다면 스케일링을 건너뛰어도 된다.
이상치를 먼저 본다. 입력 오류는 지우고, 고래 유저처럼 의미 있는 극단값은 남긴다.
StandardScaler로 기준선을 만든다.
남긴 이상치가 많다면
RobustScaler를 함께 후보에 올린다.범위 고정이 꼭 필요할 때만
MinMaxScaler를 쓴다.Pipeline에 넣고 교차검증으로 비교해 고른다.
자주 하는 실수
분할 전에 전체 데이터로
fit_transform을 호출한다 → 테스트 정보가 학습에 새어 들어간다.테스트 데이터에
fit을 다시 호출한다 → 학습과 다른 기준으로 변환된다.이상치를 그대로 둔 채
MinMaxScaler를 쓴다 → 정상값 대부분이 0 근처로 뭉개진다.열 크기를 맞추려고
Normalizer를 쓴다 → 축이 달라 의도한 효과가 나지 않는다.스케일링으로 분포가 정규분포가 되었다고 가정한다 → 왜도는 그대로다.
회귀에서 타깃을 변환하고 역변환을 잊는다 → 예측값의 단위가 달라진다.
참고 자료
scikit-learn — StandardScaler 공식 문서 (2026-08-06 확인)
scikit-learn — MinMaxScaler 공식 문서 (2026-08-06 확인)
scikit-learn — RobustScaler 공식 문서 (2026-08-06 확인)
scikit-learn — Normalizer 공식 문서 (2026-08-06 확인)
scikit-learn — 이상치가 있을 때 스케일러 비교 예제 (2026-08-06 확인)
scikit-learn — 데이터 누수와 흔한 함정 (2026-08-06 확인)
예제 데이터에 대하여
이 글의 모든 수치는 public/data/game-users.csv를 실제로 실행해 얻은 값이다. 게임 유저 4,030명의 가상 데이터이며 결측·이상치·표기 혼재를 의도적으로 심어 두었다. 실제 게임사 데이터가 아니다.
댓글 0
댓글을 불러오는 중…