선형회귀를 그대로 쌓으면 여전히 선형이다
이전 글에서 딥러닝은 “선형회귀 + 비선형성”이라고 했다. 왜 비선형성이 필요할까? 선형 함수 를 아무리 여러 층으로 쌓아도 결과는 여전히 하나의 선형식으로 정리된다. 층을 쌓는 의미가 없어지는 것이다. 각 층의 출력에 활성 함수(Activation Function)라는 비선형 함수를 끼워 넣어야, 층을 쌓을수록 더 복잡한 패턴을 표현할 수 있는 신경망이 된다.
대표 활성 함수 세 가지
함수 | 정의 | 출력 범위 | 특징 |
|---|---|---|---|
Sigmoid | 확률처럼 해석하기 좋아 이진 분류 출력층에 적합. 입력이 크거나 작으면 기울기가 0에 가까워지는 Gradient Vanishing이 발생하기 쉽다. | ||
Tanh | Sigmoid와 모양은 비슷하지만 출력이 0을 중심으로 분포해 Gradient Vanishing이 상대적으로 덜하다. RNN·LSTM에서 자주 쓰인다. | ||
ReLU | 양수는 그대로, 음수는 0으로 만든다. 계산이 간단하고 Gradient Vanishing이 적어 은닉층 기본값으로 널리 쓰인다. 다만 입력이 계속 음수면 뉴런이 죽는(dying ReLU) 문제가 있을 수 있다. |
그래프로 보는 세 함수
표만 봐서는 감이 잘 오지 않는다. 세 함수를 실제 그래프로 그려 모양을 비교해보자. 각 함수가 입력을 어떤 범위로 눌러 담는지가 핵심이다.
ReLU — 음수만 잘라낸다
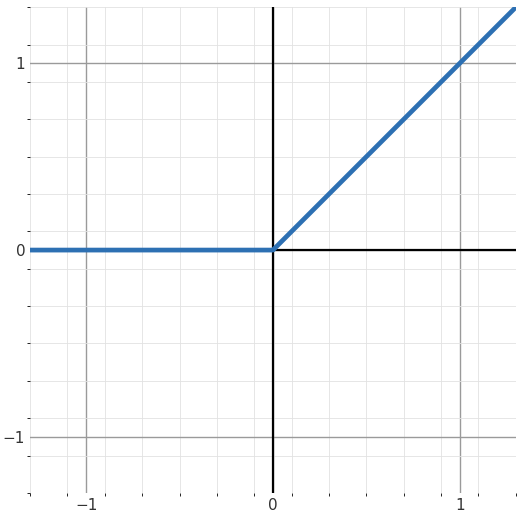
생긴 것부터 다르다. 곡선이 아니라 원점에서 한 번 꺾인 직선이다. 음수는 전부 0으로 잘라내고, 양수는 손대지 않고 그대로 통과시킨다.
양수 구간의 기울기가 계속 이라는 점이 중요하다. 입력이 아무리 커져도 기울기가 줄지 않아서, 층을 깊게 쌓아도 기울기가 살아남는다. 대신 음수 구간은 기울기가 완전히 이라, 어떤 뉴런의 입력이 계속 음수에 머물면 그 뉴런은 더 이상 학습되지 않는다. 이것이 dying ReLU 문제다.
Tanh — 0을 중심으로 대칭인 S자
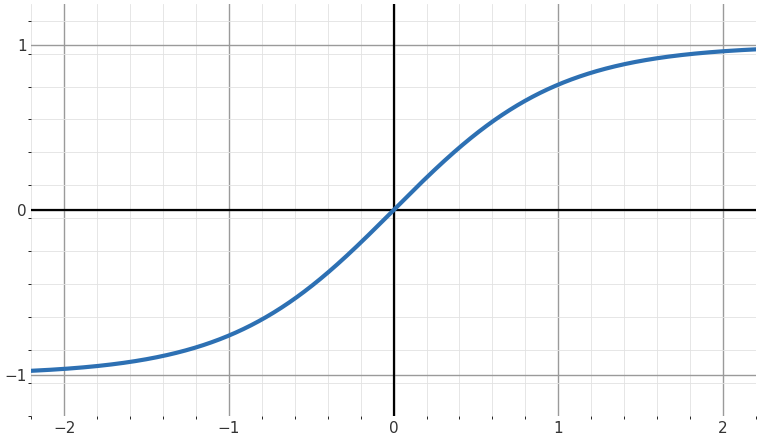
부드러운 S자 곡선이다. 원점을 지나며 를 오간다. 위아래로 대칭이라 입력이 음수면 출력도 음수, 양수면 출력도 양수가 된다.
출력의 중심이 0이라는 점이 Sigmoid와의 결정적 차이다. 다음 층에 들어가는 값이 0을 기준으로 고르게 흩어져 있어 학습이 더 안정적이다. 원점 부근의 기울기도 최대 으로 Sigmoid보다 4배 가파르다.
Sigmoid — 0과 1 사이로 눌러 담는다
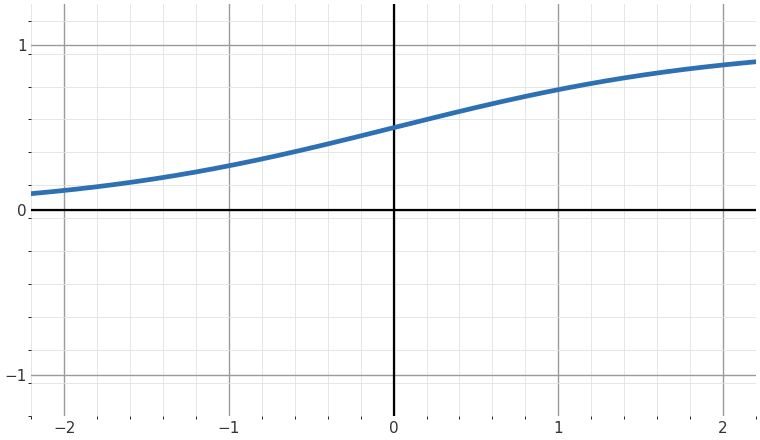
Tanh와 모양은 닮았지만 위치와 크기가 다르다. 출력이 전부 이고, 에서 를 지난다. 그래프 전체가 x축 위쪽에만 있어서 음수 출력이 나오지 않는다.
출력을 확률처럼 읽을 수 있다는 것이 가장 큰 장점이다. 그래서 이진 분류의 출력층에 잘 맞는다. 다만 기울기가 가장 가파른 원점에서도 에 불과해, 역전파에서 층을 지날 때마다 기울기가 최소 4분의 1씩 줄어든다.
셋을 겹쳐 보면
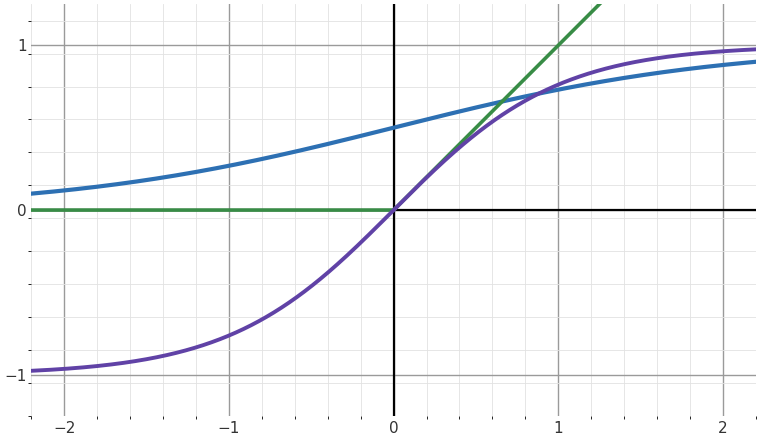
한 화면에 겹쳐 놓으면 차이가 분명해진다. 파란 선이 Sigmoid, 보라 선이 Tanh, 초록 선이 ReLU다.
세로 위치가 다르다. Sigmoid는 x축 위(0~1)에만 있고, Tanh는 x축을 가로질러 -1~1에 걸쳐 있다.
가운데 기울기가 다르다. 원점 부근에서 Tanh가 Sigmoid보다 훨씬 가파르게 올라간다.
양 끝에서 둘 다 평평해진다. Sigmoid와 Tanh 모두 좌우 끝으로 갈수록 눕는다. 반면 ReLU만 오른쪽에서 계속 직선으로 올라간다.
마지막 항목이 ReLU가 은닉층 기본값이 된 이유와 직결된다. 양 끝이 평평하다는 것은 그 구간에서 기울기가 0에 가깝다는 뜻이고, 이것이 아래에서 볼 Gradient Vanishing의 원인이 된다.
숫자로 비교한 차이
비교 항목 | Sigmoid | Tanh | ReLU |
|---|---|---|---|
출력 범위 | 0 ~ 1 | -1 ~ 1 | 0 이상 |
x = 0 | 0.5 | 0 | 0 |
출력 중심 | 0.5 (양수 쪽 치우침) | 0 (대칭) | 0 이상 |
최대 기울기 | 0.25 | 1.0 | 1 (양수 구간) |
에서의 기울기 | 0.045 | 0.010 | 1 |
모양 | S자 곡선 | S자 곡선 | 꺾인 직선 |
주 용도 | 이진 분류 출력층 | RNN·LSTM | 은닉층 기본값 |
기울기 항목을 눈여겨보자. 처럼 입력이 조금만 커져도 Sigmoid는 0.045, Tanh는 0.010까지 떨어진다. 반면 ReLU는 양수인 한 계속 1이다. 층을 여러 개 지나며 이 값들이 곱해진다고 생각하면 차이가 얼마나 벌어질지 짐작할 수 있다.
Tanh의 최대 기울기가 Sigmoid보다 크지만, 입력이 커지면 오히려 Tanh가 더 빨리 0에 가까워진다. Tanh가 Gradient Vanishing에서 완전히 자유롭다는 뜻은 아니다.
숫자로 비교해보기
import numpy as np

x = np.array([-2, -1, 0, 1, 2], dtype=float)

sigmoid = 1 / (1 + np.exp(-x))
tanh = np.tanh(x)
relu = np.maximum(0, x)

print("sigmoid:", np.round(sigmoid, 3))
print("tanh:   ", np.round(tanh, 3))
print("relu:   ", np.round(relu, 3))
sigmoid: [0.119 0.269 0.5 0.731 0.881]
tanh: [-0.964 -0.762 0. 0.762 0.964]
relu: [0. 0. 0. 1. 2.]x가 -2에서 2로 바뀔 때 Sigmoid는 0.119~0.881 사이에서 완만하게 움직이고, Tanh는 -0.964~0.964로 0을 중심으로 대칭이다. ReLU는 음수 구간을 전부 0으로 만들고 양수 구간은 입력을 그대로 통과시켜, 셋 중 계산이 가장 단순하다.
직선 세 개로 직접 확인해보기
위의 설명이 실제로 무슨 뜻인지, 직선 세 개만 가지고 눈으로 확인해보자. 준비물은 이 세 개의 1차 함수다.
아무리 더해도 직선을 벗어나지 못한다
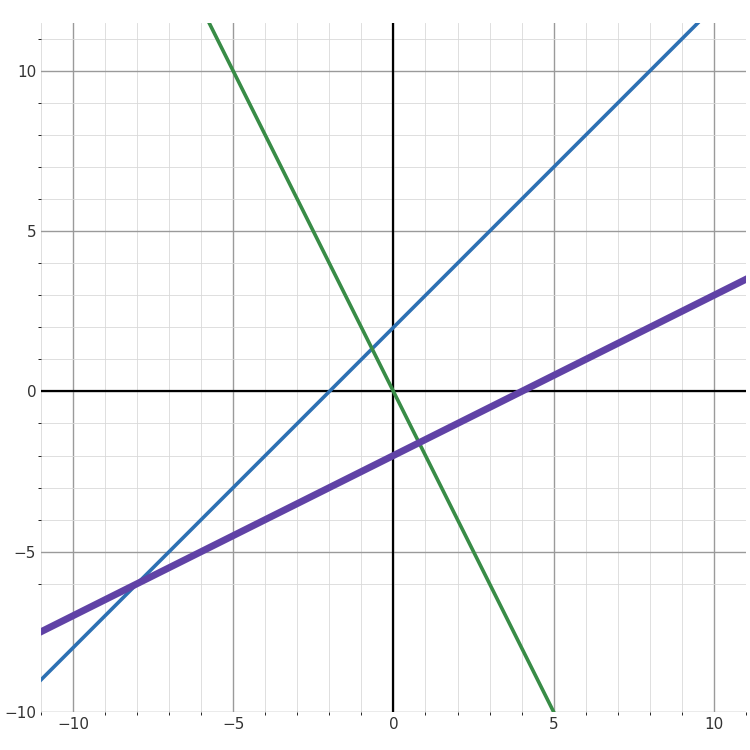
기울기도 절편도 제각각이지만, 이 셋을 더하면 어떻게 될까? 계수만 정리하면 그만이다.
결과는 또 하나의 직선이다. 가중치를 어떻게 바꿔도, 직선을 몇 개를 더하든 마찬가지다. 결과는 항상 형태를 벗어나지 못한다. 층을 아무리 깊게 쌓아도 표현할 수 있는 건 직선 하나뿐이라는 뜻이다.
이것이 활성 함수 없는 신경망의 한계다. 100층을 쌓아도 1층짜리 선형 모델과 표현력이 똑같다.
ReLU를 씌우면 꺾인다
이제 세 직선에 각각 ReLU를 적용해보자. 는 음수 구간만 0으로 눌러버린다. 곱셈도 지수도 없는 단순한 연산이지만, 이 한 번의 처리로 직선이 꺾인 선이 된다.
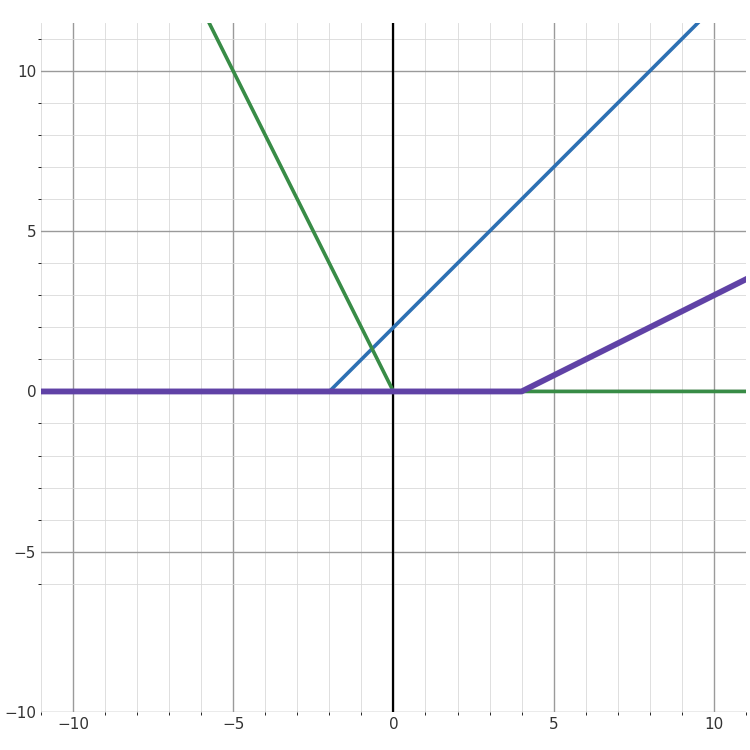
각 선이 0을 만나는 지점에서 꺾인다. 파란 선은 , 초록 선은 , 보라 선은 에서 꺾이고 그 왼쪽은 전부 0이 된다. 꺾이는 위치를 정하는 것이 바로 가중치와 편향이다. 학습이란 이 꺾이는 지점을 데이터에 맞게 옮기는 과정이다.
가중치를 주고 더하면 곡선이 만들어진다
ReLU를 통과한 세 값에 가중치 1, 1, -2를 곱해서 더해보자. 세 번째 항에만 음수 가중치를 준 것이 핵심이다.
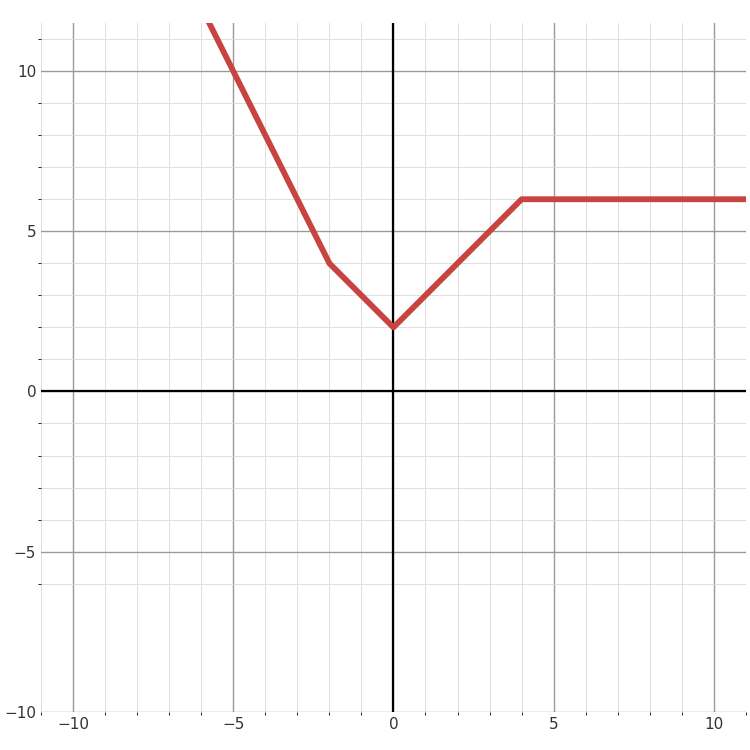
더 이상 직선이 아니다. 내려오다가 올라가고, 어느 지점부터는 평평해진다. 직선만 더했는데 직선이 아닌 모양이 나왔다. 활성 함수 하나를 끼워 넣었을 뿐인데 표현할 수 있는 모양이 완전히 달라진 것이다.
숫자로 확인하면 꺾이는 지점이 분명하게 보인다.
import numpy as np

def relu(v):
    return np.maximum(0, v)

x = np.array([-6, -2, 0, 2, 4, 6, 10], dtype=float)

# 세 직선을 그냥 더하면
linear_sum = (x + 2) + (-2 * x) + (0.5 * x - 2)

# ReLU를 씌우고 가중치 1, 1, -2로 더하면
relu_sum = relu(x + 2) + relu(-2 * x) - 2 * relu(0.5 * x - 2)

print("x         :", x)
print("linear    :", linear_sum)
print("relu(w합) :", relu_sum)
x : [-6. -2. 0. 2. 4. 6. 10.]
linear : [ 3. 1. 0. -1. -2. -3. -5.]
relu(w합) : [12. 4. 2. 4. 6. 6. 6.]가운데 줄은 그대로라 일정하게 감소하기만 한다. 반면 아래 줄은 12 → 2로 내려왔다가 다시 6까지 올라간 뒤, 부터는 계속 6에 머문다. 방향이 두 번 바뀌고 평평해지는 구간까지 생겼다.
여기서 알 수 있는 것
직선은 몇 개를 더해도 직선이다. 활성 함수가 없으면 층을 쌓는 의미가 없다.
비선형성은 꺾임에서 나온다. ReLU는 음수를 0으로 만드는 것만으로 꺾인 지점을 만든다.
가중치는 모양을 결정한다. 어디서 꺾이고 얼마나 가파른지가 가중치와 편향으로 정해지며, 학습은 이 값을 찾는 과정이다.
ReLU 조각을 충분히 많이 모으면 어떤 복잡한 곡선이든 근사할 수 있다. 신경망이 곡선을 그리는 방식은 곡선 함수를 쓰는 것이 아니라, 꺾인 직선을 아주 많이 이어 붙이는 것에 가깝다.
어디에 무엇을 쓸까
은닉층 기본값 — 대부분의 신경망에서 ReLU를 기본으로 쓰고, dying ReLU 문제가 걱정되면 Leaky ReLU 같은 변형을 검토한다.
이진 분류 출력층 — 확률처럼 0~1 사이 값이 필요하면 Sigmoid를 출력층에 쓴다.
순환 신경망(RNN·LSTM) — 출력이 양수·음수로 고르게 나뉘는 문제라면 Tanh가 자주 쓰인다.
Gradient Vanishing과의 관계
Sigmoid와 Tanh는 입력이 아주 크거나 작을 때 그래프가 평평해진다. 이 구간에서는 기울기(Gradient)가 0에 가까워지는데, 층이 깊어질수록 이 작은 기울기들이 역전파 과정에서 계속 곱해지며 앞쪽 층까지 거의 0에 가까운 신호만 전달된다 — 이것이 Gradient Vanishing(기울기 소실) 문제다. ReLU는 양수 구간에서 기울기가 항상 1로 일정해 이 문제를 상당히 줄여준다. 다음 딥러닝 아키텍처 시리즈에서 Gradient Vanishing/Exploding을 더 자세히 다룬다.
정리
활성 함수는 신경망에 비선형성을 더해 층을 쌓는 의미를 만들어준다. 확률이 필요하면 Sigmoid, 0 중심 출력이 필요하면 Tanh, 특별한 이유가 없다면 계산이 간단하고 기울기 소실에 강한 ReLU를 은닉층 기본값으로 쓰는 것이 일반적인 시작점이다.
참고 자료
Rectified Linear Units Improve Restricted Boltzmann Machines (Nair & Hinton, ICML 2010) — ReLU를 신경망 학습에 도입해 효과를 검증한 원 논문 (2026-08-07 확인)
torch.nn — Non-linear Activations, PyTorch 공식 문서 — Sigmoid·Tanh·ReLU 등 활성 함수의 공식 API 정의 (2026-08-07 확인)
댓글 0
댓글을 불러오는 중…