Dropout은 과적합을 줄이는 정규화다
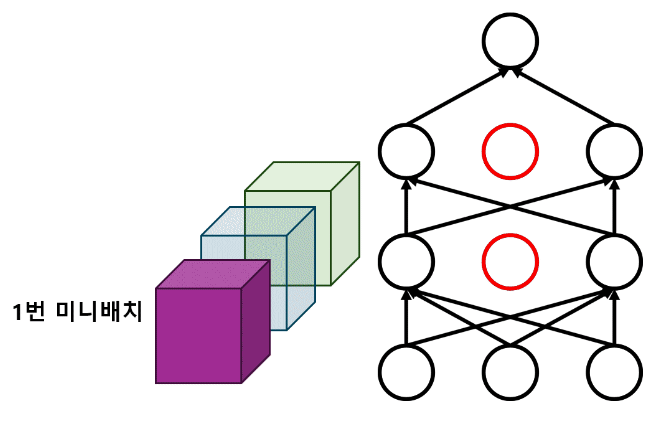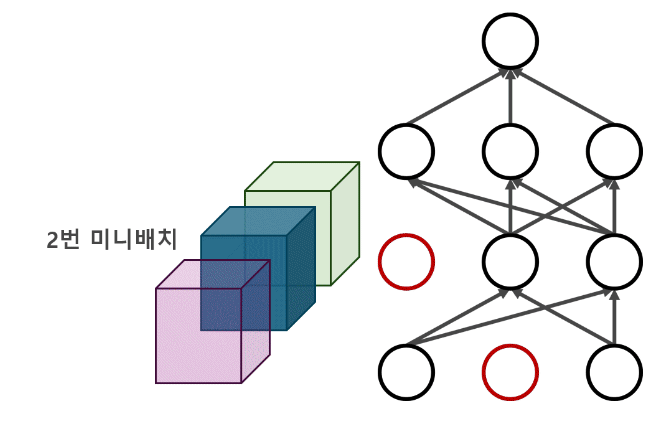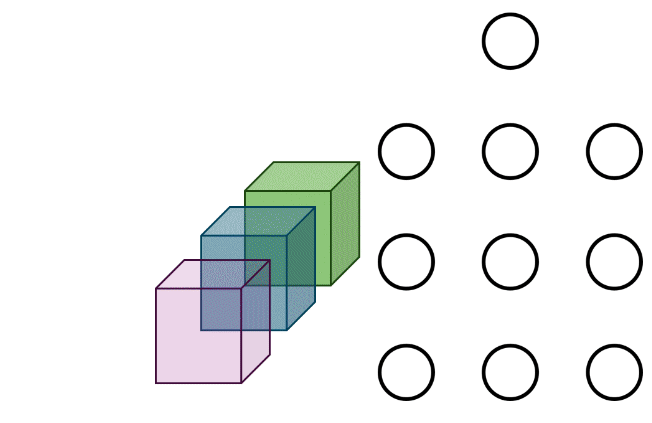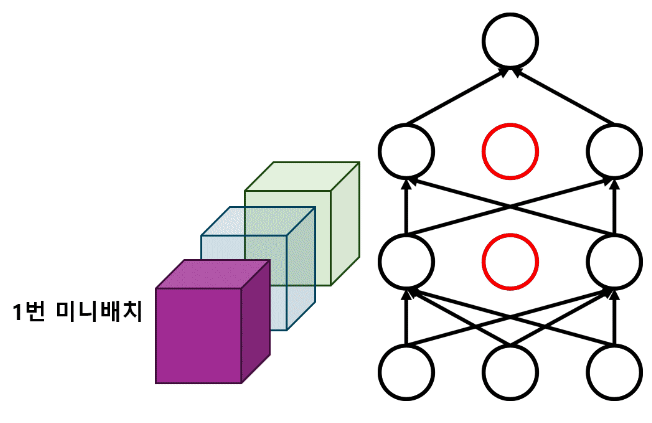
Dropout은 학습할 때마다 은닉층 뉴런의 출력 일부를 무작위로 0으로 만든다.(꺼버린다) 매 배치가 서로 다른 얇은 부분 네트워크를 사용하므로, 특정 뉴런들이 항상 같이 작동하며 서로의 존재에 과도하게 의존하는 공적응(co-adaptation)을 억제한다. 이는 기울기 소실·폭발의 해결책이 아니라 모델의 일반화를 돕는 별도의 기법이다.
학습 중에만 마스크를 적용한다
드롭 확률을 , 유지 확률을 라고 하면 매 출력에 독립적인 Bernoulli 마스크를 곱한다. 현대 프레임워크는 대개 inverted dropout을 사용해 남은 신호를 학습 중에 배 확대한다.
이 스케일링으로 학습 중 출력의 기대값이 원래 출력과 같아진다. 따라서 평가·추론 모드에서는 모든 뉴런을 사용하면서 별도의 스케일 조정을 하지 않아도 된다.
확률 p를 선택하는 법
p=0은 드롭아웃을 사용하지 않는다는 뜻이다.
p가 너무 크면 유용한 신호까지 많이 사라져 과소적합과 학습 지연이 생길 수 있다.
후보 값을 검증 데이터로 비교하고, 모델 크기·데이터 양·다른 정규화와의 조합을 함께 고려한다.
Dropout(p=0.2) 미니배치마다 랜덤으로 꺼진다. 반복을 엄청 많이 하기 떄문에 확률상 1번씩은 모두 학습된다.
PyTorch에서 학습·평가 모드 확인하기
import torch
from torch import nn

torch.manual_seed(7)
dropout = nn.Dropout(p=0.5)
x = torch.ones(8)

dropout.train()
print(dropout(x))

dropout.eval()
print(dropout(x))
tensor([2., 0., 0., 2., 2., 2., 2., 0.])
tensor([1., 1., 1., 1., 1., 1., 1., 1.])검증·테스트 전에 model.eval()을 호출하지 않으면 Dropout이 계속 활성화되어 같은 입력의 예측이 매번 달라질 수 있다. 반대로 학습을 재개할 때는 model.train()으로 되돌린다.
정리
Dropout은 학습 중 무작위 마스크와 inverted scaling을 적용해 뉴런 간 과도한 의존을 줄인다. 평가 중에는 비활성화하며, 강도는 검증 성능으로 선택해야 한다. 이를 기울기 안정화 기법과 같은 문제의 해결책으로 혼동하지 않는 것이 중요하다.
참고 자료
Dropout: A Simple Way to Prevent Neural Networks from Overfitting — Dropout 원 논문 (2026-08-10 확인)
torch.nn.Dropout 공식 문서 — 학습 중 스케일링과 평가 중 항등 함수 동작 (2026-08-10 확인)
댓글 0
댓글을 불러오는 중…