산 정상에서 최적점까지 내려가는 길
경사하강법(Gradient Descent)은 손실함수의 기울기(Gradient)를 보고, 그 값이 줄어드는 방향으로 파라미터를 조금씩 옮겨가며 손실이 최소가 되는 지점을 찾는 최적화 방법이다. 등산객이 산 정상(초기 가중치)에서 출발해 경사면을 보고 방향을 정하며 산 아래(최적점)로 내려가는 상황에 비유할 수 있다.
가중치 업데이트 공식
기호 | 의미 | 등산 비유 |
|---|---|---|
W_old | 현재 가중치(위치) | 지금 서 있는 위치 |
η (eta) | 학습률(Learning Rate) — 사람이 정하는 하이퍼파라미터 | 한 걸음에 내려갈 거리 |
∂E / ∂W_old | 현재 위치에서 손실함수(E)의 기울기 — 방향과 크기 정보를 담음 | 경사면이 얼마나 가파르고 어느 방향인지 |
W_new | 한 걸음 내려간 뒤의 새 가중치 | 한 걸음 내려간 다음 위치 |
기울기는 “손실이 커지는 방향”을 가리키므로, 그 반대 방향()으로 이동해야 손실이 줄어든다. 이 계산을 반복하면 가중치가 손실이 최소가 되는 지점으로 조금씩 다가간다.
Learning Rate: 한 걸음의 크기
학습률은 보통 0과 1 사이 값으로 사람이 직접 정한다.
학습률이 너무 작으면 — 아주 조심스럽게 한 발씩 내려가 안전하지만, 최적점까지 도달하는 데 시간이 오래 걸린다.
학습률이 너무 크면 — 두세 발자국씩 뛰어 내려가다가 최적점을 지나쳐버리는 Over-shooting이 발생할 수 있다.
실무에서는 10⁻⁵ 근처의 작은 값에서 시작해 하이퍼파라미터 튜닝으로 최적값을 찾는 경우가 많고, 학습 초반에는 크게 움직이다 최적점에 가까워질수록 보폭을 줄이는 스케줄링을 쓰기도 한다.
그래프로 따라가 보기: η = 0.5
앞의 공식이 실제로 어떻게 움직이는지, 손실함수 하나를 놓고 손으로 계산해 본다. 아래 그래프의 빨간 점이 출발 위치다.
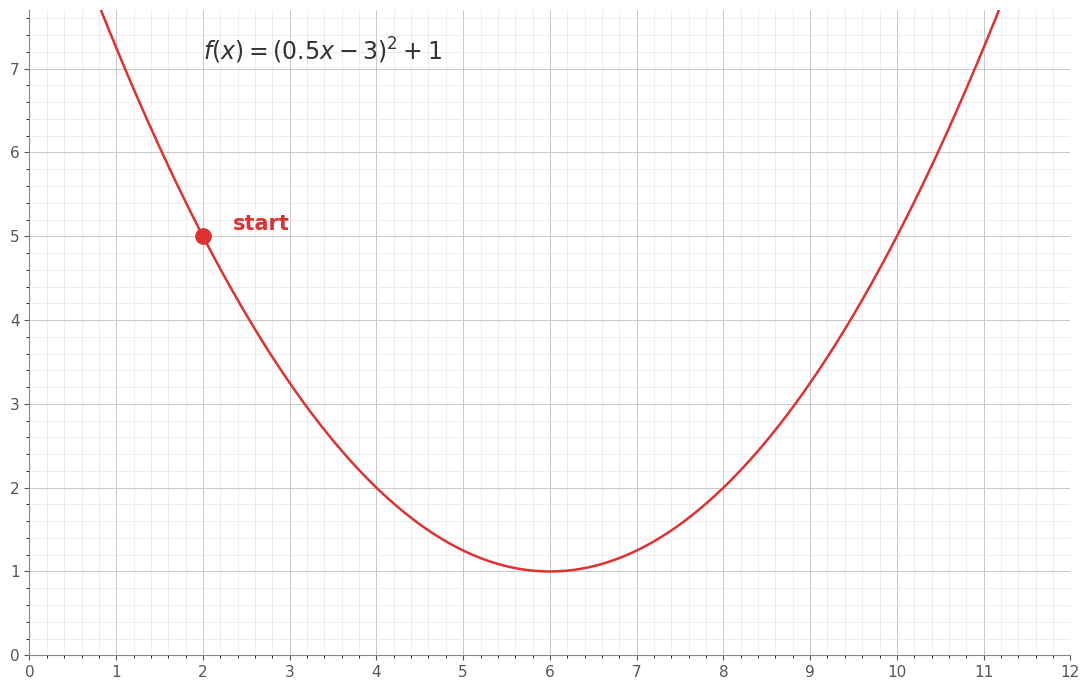
그래프에서 시작점은 이고, 이므로 좌표는 다. 곡선의 최소점은 인 이고 그때 이다. 경사하강법이 이 지점을 찾아내는지 확인하는 것이 목표다.
1. 미분해서 기울기 구하기
합성함수 미분(연쇄법칙)으로 기울기를 구한다.
정리하면 기울기 함수는 다음과 같다.
앞에서 본 가중치 업데이트 공식을 이 문제에 맞게 쓰면 자리에 가 들어간다.
학습률 를 넣으면 이번 문제의 갱신 규칙이 정해진다.
2. 시작점에서 한 걸음 옮기기
현재 위치는 다. 이 지점의 기울기는
기울기가 음수 라는 것은 지금 서 있는 자리에서 오른쪽으로 갈수록 손실이 줄어든다는 뜻이다. 공식에 넣으면
음수 기울기에 음수 부호가 붙어 오른쪽으로 1만큼 이동했다. 손실은 에서 로 줄었다. 공식이 스스로 방향을 찾아낸 것이다.
3. 같은 계산을 반복하면
한 걸음을 그대로 여섯 번 더 반복한 결과다.
스텝 | x | f(x) | f'(x) |
|---|---|---|---|
2.0000 | 5.0000 | -2.0000 | |
3.0000 | 3.2500 | -1.5000 | |
3.7500 | 2.2656 | -1.1250 | |
4.3125 | 1.7119 | -0.8438 | |
4.7344 | 1.4005 | -0.6328 | |
5.0508 | 1.2253 | -0.4746 | |
5.2881 | 1.1267 | -0.3560 |
최소점 에 가까워질수록 기울기의 크기가 처럼 저절로 작아지고, 그만큼 한 걸음의 폭도 함께 줄어든다. 학습률을 건드리지 않았는데도 최적점 근처에서 자동으로 조심스러워지는 것이 경사하강법의 성질이다. 기울기가 0인 최소점에서는 이동량도 0이 되어 그 자리에 머문다.
점 사이의 간격이 뒤로 갈수록 촘촘해지는 것이 위 표의 기울기 감소와 같은 이야기다. 다만 는 이 함수에서 7스텝을 써도 까지만 왔다 — 최소점에 무한히 가까워지지만 정확히 도달하지는 않는다. 실무에서 학습을 언제 멈출지(Epoch 수, Early Stopping)를 따로 정해야 하는 이유다.
코드로 학습률의 영향 확인하기
앞 절에서 손으로 계산한 그 함수 을 그대로 코드로 옮겨, 학습률만 바꿔가며 10번씩 반복해 본다. 기울기는 이고 시작점도 같은 다.
def f(x):
    return (0.5 * x - 3) ** 2 + 1

def grad(x):
    return 0.5 * x - 3

for lr in [0.05, 0.5, 4.5]:
    x = 2.0
    for _ in range(10):
        x = x - lr * grad(x)
    print(f"lr={lr}: x={x:.4f}, f(x)={f(x):.4f}")
lr=0.05: x=2.8947, f(x)=3.4108
lr=0.5: x=5.7747, f(x)=1.0127
lr=4.5: x=-31.2529, f(x)=347.9447는 10번을 반복해도 — 최소점 까지 절반도 못 갔다. 너무 조심스럽다. 는 로 최소점에 거의 닿았고 손실도 최소값 에 근접한 이다. 는 한 걸음이 너무 커서 최소점을 계속 뛰어넘으며 손실이 오히려 커지는 발산(Divergence) 상태가 됐다 — 손실이 까지 벌어졌다. 같은 함수·같은 출발점인데 학습률 하나가 결과를 완전히 바꾼다.
한계: Local Minimum
경사하강법은 현재 위치의 지역 정보(기울기)만 보고 이동하기 때문에, 가장 낮은 지점(Global Minimum)이 아니라 주변보다만 낮은 골짜기(Local Minimum)에 갇힐 수 있다. 경사면이 완만하면 이동이 느려지고, 출발 위치에 따라 결과가 달라질 수 있다는 한계도 있다. 이 한계를 보완하려는 시도가 다음 글에서 다룰 Optimizer(Momentum, Adam 등)다.
골짜기가 두 개인 손실함수
지금까지 쓴 은 골짜기가 하나뿐이라 어디서 출발하든 같은 곳에 도착했다. 실제 신경망의 손실함수는 그렇지 않다. 아래처럼 골짜기가 둘 이상이면 이야기가 달라진다.
이 함수는 바닥이 두 곳이다. 왼쪽 에서 손실은 으로 가장 낮고(Global Minimum), 오른쪽 에서 손실은 다(Local Minimum). 두 골짜기 사이에는 을 꼭대기로 하는 언덕이 있다.
두 지점 모두 기울기가 이다. 경사하강법은 기울기만 보고 움직이므로 둘을 구별하지 못한다. 기울기가 0이 되면 갱신량도 0이 되어 그 자리에서 멈춘다.
시작점 x = 4에서 내려가 보기
위 그래프의 빨간 세모 에서 로 출발하면 어떻게 되는지 따라가 본다. 이 지점의 기울기는 로 양수이므로 왼쪽으로 이동한다.
스텝 | x | f(x) | f'(x) |
|---|---|---|---|
0 | 4.000 | 3.680 | 6.920 |
1 | 3.308 | 0.875 | 1.669 |
2 | 3.141 | 0.670 | 0.813 |
3 | 3.060 | 0.619 | 0.448 |
4 | 3.015 | 0.603 | 0.261 |
5 | 2.989 | 0.598 | 0.156 |
50 | 2.948 | 0.595 | 0.000 |
50번을 반복해도 에서 멈춘다. 손실은 다. 왼쪽 골짜기의 보다 한참 높은데도 더 내려가지 않는다. 언덕 반대편이 더 낮다는 사실을 알려면 언덕을 넘어가 봐야 하지만, 경사하강법은 지금 서 있는 자리의 기울기 하나만 본다. 눈앞이 평평하니 도착했다고 판단하는 것이다.
출발 위치가 결과를 가른다
같은 함수, 같은 학습률로 시작점만 으로 바꾸면 결과가 뒤집힌다. 아래 그래프에서 두 경로가 같은 학습률로 동시에 출발해 서로 다른 골짜기로 갈라지는 것을 볼 수 있다.
시작점 | 50스텝 뒤 x | 손실 | 도착지 |
|---|---|---|---|
x = 4 | 2.948 | 0.595 | Local Minimum |
x = 0 | -2.049 | -0.405 | Global Minimum |
갈림길은 언덕 꼭대기 이다. 이 점보다 오른쪽에서 출발하면 오른쪽 골짜기로, 왼쪽에서 출발하면 왼쪽 골짜기로 굴러떨어진다. 알고리즘도 학습률도 똑같은데 처음 놓인 자리 하나로 최종 성능이 갈린다. 신경망의 가중치를 무작위로 초기화하는 것이 결과에 영향을 주는 이유가 여기에 있다.
def f(x):
    return 0.08 * (x + 2) ** 2 * (x - 3) ** 2 + 0.2 * x

def grad(x):
    return 0.08 * (2 * (x + 2) * (x - 3) ** 2 + 2 * (x + 2) ** 2 * (x - 3)) + 0.2

for start in [4.0, 0.0]:
    x = start
    for _ in range(50):
        x = x - 0.1 * grad(x)
    print(f"start={start}: x={x:.3f}, f(x)={f(x):.3f}")
start=4.0: x=2.948, f(x)=0.595
start=0.0: x=-2.049, f(x)=-0.405그래서 무엇을 하는가
Local Minimum은 경사하강법을 버릴 이유가 아니라, 보완이 필요한 지점이다. 실무에서 쓰는 방법은 대체로 세 갈래다.
관성을 준다 — Momentum 계열은 직전까지의 이동 방향을 일부 유지한다. 얕은 골짜기는 관성으로 타고 넘어갈 수 있다. 다음 글의 Optimizer가 여기에 해당한다.
무작위성을 섞는다 — 미니배치마다 기울기가 조금씩 달라지는 SGD의 흔들림 자체가 얕은 골짜기를 빠져나오는 힘이 된다.
시작점을 여러 번 바꾼다 — 초기화를 달리해 여러 번 학습하고 가장 좋은 결과를 고른다. 위 표에서 시작점만 바꿔 결과가 뒤집힌 것과 같은 원리다.
덧붙이면, 위 예시처럼 입력이 하나뿐인 그림은 이해를 위한 단순화다. 가중치가 수백만 개인 실제 신경망에서는 모든 방향으로 동시에 오목한 진짜 Local Minimum이 오히려 드물고, 어떤 방향으로는 올라가고 어떤 방향으로는 내려가는 안장점(Saddle Point)이 학습을 더 자주 붙잡는 것으로 알려져 있다. 기울기가 0이라 멈춘다는 문제의 본질은 같다.
정리
경사하강법은 손실함수의 기울기를 따라 손실이 줄어드는 방향으로 가중치를 반복해서 조금씩 옮기는 방법이다. 그 한 걸음의 크기가 Learning Rate이며, 너무 작으면 느리고 너무 크면 발산한다. 적절한 학습률을 찾는 것 자체가 하이퍼파라미터 튜닝의 핵심 과제 중 하나다.
참고 자료
CS231n: Optimization notes — Stanford University — 경사하강법·학습률이 손실 수렴에 미치는 영향에 대한 공식 강의 노트 (2026-08-07 확인)
댓글 0
댓글을 불러오는 중…