이상치(outlier)는 다른 값들과 뚝 떨어져 있는 값이다. 여기서 초보자가 가장 많이 하는 실수는 이상치를 발견하자마자 지우는 것이다. 하지만 지워야 할 이상치와 절대 지우면 안 되는 이상치는 숫자만 봐서는 구분되지 않는다.
999세는 지워야 한다. 1,200만원을 결제한 유저는 지우면 안 된다. 둘 다 IQR에는 똑같이 '이상치'로 잡힌다. 이 글은 게임 유저 4,030명의 CSV 하나를 끝까지 따라가며 그 둘을 가르는 방법을 다룬다.
이 글은 결측치 처리: 원인부터 찾는 삭제와 대치와 같은 데이터를 쓴다. 두 글을 이어서 읽으면 같은 CSV로 전처리 한 바퀴를 돌게 된다.
예제 데이터 불러오기
데이터는 이 사이트에 공개되어 있다. 아래 코드를 그대로 실행하면 내려받지 않고 바로 읽을 수 있다.
import pandas as pd
import numpy as np
from urllib.request import Request, urlopen

URL = "https://1000page.pages.dev/data/game-users.csv"
request = Request(URL, headers={"User-Agent": "Mozilla/5.0"})
with urlopen(request, timeout=30) as response:
    df = pd.read_csv(response)

print(df.shape)
(4030, 14)게임 유저 한 명이 한 행이다. 나이, 누적 플레이타임, 평균 세션 길이, 결제액, 레벨 등이 열로 들어 있다. 이 데이터에는 지워야 할 오류와 지우면 안 되는 극단값이 섞여 심어져 있다.
urlopen에User-Agent를 붙이는 이유는 일부 CDN이 기본 파이썬 요청을 막기 때문이다. 로컬 파일이라면pd.read_csv("game-users.csv")처럼 경로만 넣으면 된다.
1단계: describe()로 이상한 냄새를 맡는다
탐지 기법을 꺼내기 전에 describe()부터 본다. 최솟값과 최댓값만 봐도 대부분의 입력 오류가 드러난다.
cols = ["age", "total_playtime_hours", "avg_session_min", "total_purchase_krw"]
print(df[cols].describe().loc[["count", "mean", "std", "min", "50%", "max"]].round(1))
age total_playtime_hours avg_session_min total_purchase_krw
count 3835.0 4030.0 4030.0 4030.0
mean 37.6 297.9 41.9 35918.6
std 23.7 912.8 60.0 509875.4
min -36.0 -403.9 0.0 0.0
50% 36.0 144.6 32.9 0.0
max 999.0 20434.1 1337.5 11671314.0네 줄만 읽으면 된다.
age의 최솟값이-36이고 최댓값이999다. 둘 다 사람 나이일 수 없다. 명백한 입력 오류다.total_playtime_hours에 음수가 있다. 누적 시간이 음수일 수는 없다.avg_session_min의 최솟값이0이다. 접속하자마자 튕긴 로그로 보인다.total_purchase_krw는 중앙값이 0인데 최댓값이 1,167만원이다. 이건 오류가 아닐 가능성이 높다. 과금 게임에는 원래 이런 유저가 있다.
여기서 이미 갈린다. 앞의 셋은 물리적으로 불가능한 값이고, 마지막 하나는 '드물지만 실제로 존재하는 값'이다. 평균과 표준편차도 눈여겨볼 만하다. 플레이타임 평균이 297.9시간인데 중앙값은 144.6시간이다. 평균이 중앙값의 두 배라는 것은 소수의 거대한 값이 평균을 끌어올리고 있다는 뜻이다.
2단계: 통계보다 업무 기준이 먼저다
IQR도 Z-score도 아직 필요 없다. 정의상 불가능한 값은 통계 없이 조건문만으로 잡힌다. 그리고 이게 가장 확실한 방법이다.
snapshot = pd.Timestamp("2026-08-01")   # 데이터 추출 기준일

checks = {
    "age: 13세 미만/90세 초과": ((df["age"] < 13) | (df["age"] > 90)).sum(),
    "playtime: 음수":         (df["total_playtime_hours"] < 0).sum(),
    "session: 0분":           (df["avg_session_min"] == 0).sum(),
    "signup: 미래 날짜":       (pd.to_datetime(df["signup_date"]) > snapshot).sum(),
}
for name, count in checks.items():
    print(f"{name:22s} {count:3d}건")
age: 13세 미만/90세 초과 18건
playtime: 음수 6건
session: 0분 40건
signup: 미래 날짜 3건67건이 걸렸다. 여기서 쓴 기준은 통계에서 나온 게 아니다.
13세 — 게임 서비스 이용약관상 가입 하한선
90세 — 불가능하진 않지만 확인이 필요한 선
음수 플레이타임 — 집계 시스템의 버그
미래 가입일 — 서버 시간 오류
업무 기준으로 잡은 값은 오탐이 없다. 음수 플레이타임은 100% 오류다. 반면 통계 기법으로 잡은 값은 항상 '정상일 수도 있는' 값이 섞인다. 그래서 순서가 중요하다. 업무 기준을 먼저 적용해 확실한 오류를 걷어낸 다음, 남은 것에 통계를 쓴다.
3단계: IQR — 중앙값 기준으로 자르기
이제 통계 기법이다. IQR(사분위 범위)은 데이터를 크기순으로 줄 세운 뒤 가운데 50%가 차지하는 폭을 말한다.
Q1— 아래에서 25% 지점Q3— 아래에서 75% 지점IQR = Q3 - Q1— 가운데 50%의 폭
이 폭의 1.5배를 위아래로 더 뻗은 지점이 경계다. 그 바깥을 이상치 후보로 본다. 박스플롯의 수염 끝이 정확히 이 값이다.
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"   # 맥은 "AppleGothic"
plt.rcParams["axes.unicode_minus"] = False

normal_age = df["age"][(df["age"] >= 13) & (df["age"] <= 90)]
plt.figure(figsize=(9, 4))
plt.boxplot(normal_age, vert=False, widths=0.4)
plt.xlabel("age")
plt.show()
(그래프 출력)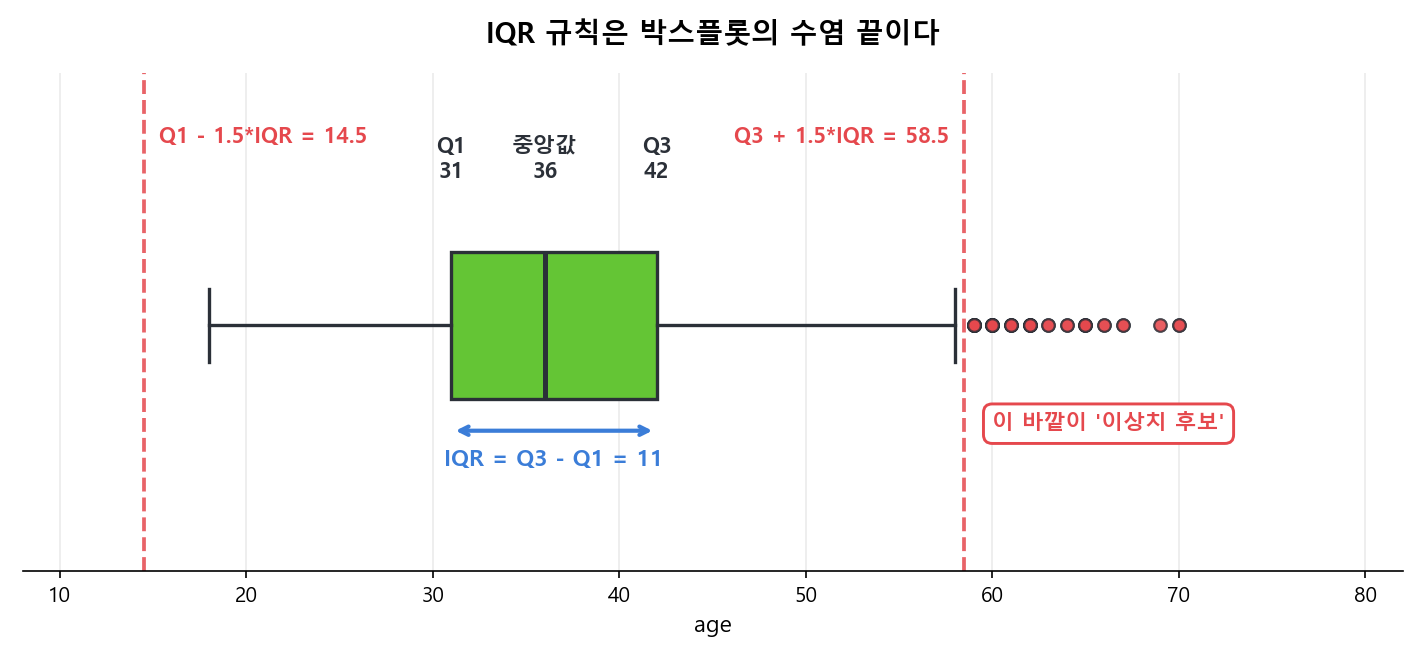
왜 하필 1.5배인지 궁금할 수 있다. 정규분포를 가정하면 이 경계가 대략 상위·하위 0.7%씩을 잘라내는 위치다. 통계학자 존 튜키가 제안한 관습적인 값이지 자연법칙이 아니다. 더 보수적으로 잡고 싶으면 3.0배를 쓴다.
여러 열에 한 번에 적용해 본다.
def iqr_outliers(s, k=1.5):
    q1, q3 = s.quantile(0.25), s.quantile(0.75)
    iqr = q3 - q1
    lower, upper = q1 - k * iqr, q3 + k * iqr
    mask = (s < lower) | (s > upper)
    return lower, upper, mask.sum()


rows = []
for col in ["age", "total_playtime_hours", "avg_session_min", "total_purchase_krw"]:
    s = df[col].dropna()
    lower, upper, n = iqr_outliers(s)
    rows.append([col, round(lower, 1), round(upper, 1), n, round(n / len(s) * 100, 1)])

print(pd.DataFrame(rows, columns=["컬럼", "하한", "상한", "이상치수", "비율(%)"]).to_string(index=False))
컬럼 하한 상한 이상치수 비율(%)
age 14.5 58.5 83 2.2
total_playtime_hours -296.2 662.8 343 8.5
avg_session_min -20.2 91.0 178 4.4
total_purchase_krw -3862.5 6437.5 830 20.6마지막 줄을 보자. 결제액의 20.6%, 830명이 이상치로 잡혔다. 전체의 5분의 1이 이상치라는 결론은 말이 되지 않는다.
원인은 분포에 있다. 이 데이터는 73%가 무과금이라 Q1도 0원, 중앙값도 0원이다. Q3만 2,575원이라 IQR이 2,575원밖에 안 되고, 상한이 6,438원으로 잡힌다. 실제로 결제한 유저의 중앙값은 17,050원이므로 이 상한은 평범한 과금 유저보다도 낮다. 그 결과 6,438원을 결제한 평범한 유저까지 전부 이상치가 된다.
IQR은 한쪽으로 심하게 치우친 분포에서 오작동한다. 결제액처럼 0이 대부분인 열, 플레이타임처럼 롱테일인 열이 대표적이다. 이런 열은 0을 제외하고 계산하거나, 로그를 씌운 뒤 적용하거나, 애초에 IQR을 쓰지 않는 편이 낫다.
4단계: Z-score — 평균에서 몇 배 떨어졌나
Z-score는 각 값이 평균에서 표준편차의 몇 배만큼 떨어져 있는지를 잰다. 보통 |z| > 3을 이상치로 본다.
age = df["age"].dropna()
z = (age - age.mean()) / age.std()

print(f"평균 {age.mean():.2f}, 표준편차 {age.std():.2f}")
print(f"|z| > 3 인 값: {(z.abs() > 3).sum()}건")
평균 37.57, 표준편차 23.74
|z| > 3 인 값: 6건6건이다. 그런데 2단계에서 업무 기준으로 찾은 나이 오류는 18건이었다. Z-score가 12건을 놓쳤다. 무엇을 놓쳤는지 확인해 본다.
errors = (age < 13) | (age > 90)      # 업무 기준으로 확정한 진짜 오류
missed = age[errors & (z.abs() <= 3)]
print(sorted(missed.tolist()))
[-32.0, -21.0, -9.0, -4.0, -4.0, 2.0, 3.0, 3.0, 3.0, 3.0, 3.0, 5.0]음수 나이와 3세를 통째로 놓쳤다. 누가 봐도 오류인 값들이다. 이유는 하나다.
마스킹 — 이상치가 이상치를 숨긴다
Z-score는 평균과 표준편차로 계산된다. 그런데 평균과 표준편차 자체가 이상치에 오염된다. 999세 두 건이 표준편차를 23.74까지 부풀렸고, 그 결과 3세가 평균에서 겨우 1.46배 떨어진 '평범한 값'이 되어 버렸다.
print(f"{'':14s} {'평균':>8s} {'표준편차':>8s} {'z(3세)':>8s}")
print(f"{'999 포함':14s} {age.mean():8.2f} {age.std():8.2f} {(3 - age.mean()) / age.std():8.2f}")

age2 = age[age < 200]                 # 999세만 빼고 다시 계산
print(f"{'999 제외':14s} {age2.mean():8.2f} {age2.std():8.2f} {(3 - age2.mean()) / age2.std():8.2f}")
평균 표준편차 z(3세)
999 포함 37.57 23.74 -1.46
999 제외 37.07 9.01 -3.78999 두 건을 빼자 표준편차가 23.74에서 9.01로 떨어지고, 3세의 z가 -1.46에서 -3.78로 바뀌었다. 이제야 이상치로 잡힌다. 이것을 마스킹(masking)이라고 한다. 극단적인 이상치 하나가 다른 이상치들을 가려 버리는 현상이다.
Z-score는 이상치를 찾는 데 이상치에 취약한 통계량을 쓴다는 모순이 있다. 그래서 정규분포에 가깝고 극단값이 심하지 않은 열에서만 쓸 만하다.
대안: 중앙값 기반 수정 Z-score
평균 대신 중앙값을, 표준편차 대신 MAD(중앙값 절대 편차)를 쓰면 마스킹을 피할 수 있다. 중앙값은 극단값에 흔들리지 않기 때문이다.
median = age.median()
mad = (age - median).abs().median()
robust_z = 0.6745 * (age - median) / mad     # 0.6745는 정규분포 기준 보정 상수

print(f"중앙값 {median:.1f}, MAD {mad:.1f}")
print(f"수정 z(3세)   = {0.6745 * (3 - median) / mad:.2f}")
print(f"수정 z(999세) = {0.6745 * (999 - median) / mad:.2f}")
print(f"|수정 z| > 3.5 : {(robust_z.abs() > 3.5).sum()}건")
중앙값 36.0, MAD 5.0
수정 z(3세) = -4.45
수정 z(999세) = 129.91
|수정 z| > 3.5 : 49건3세가 -4.45로 제대로 잡히고, 999세는 129.91이라는 압도적인 값이 나온다. 일반 Z-score가 놓쳤던 오류 18건을 모두 잡아낸다. 다만 49건 중 31건은 62~70세의 정상 유저다. 오탐이 여전히 있다는 뜻이다.
5단계: 세 방법을 나란히 비교한다
같은 열에 세 방법을 걸어 무엇을 잡고 무엇을 놓치는지 정리한다. 이 데이터는 정답을 알고 있으므로(오류 18건) 채점이 가능하다.
lower, upper, _ = iqr_outliers(age)
iqr_flag = (age < lower) | (age > upper)
z_flag = z.abs() > 3
errors = (age < 13) | (age > 90)          # 정답

comparison = pd.DataFrame({
    "방법": ["Z-score |z|>3", "IQR 1.5배", "업무 기준"],
    "탐지": [z_flag.sum(), iqr_flag.sum(), errors.sum()],
    "진짜오류": [(errors & z_flag).sum(), (errors & iqr_flag).sum(), errors.sum()],
    "오탐": [(~errors & z_flag).sum(), (~errors & iqr_flag).sum(), 0],
})
print(comparison.to_string(index=False))
방법 탐지 진짜오류 오탐
Z-score |z|>3 6 6 0
IQR 1.5배 83 18 65
업무 기준 18 18 0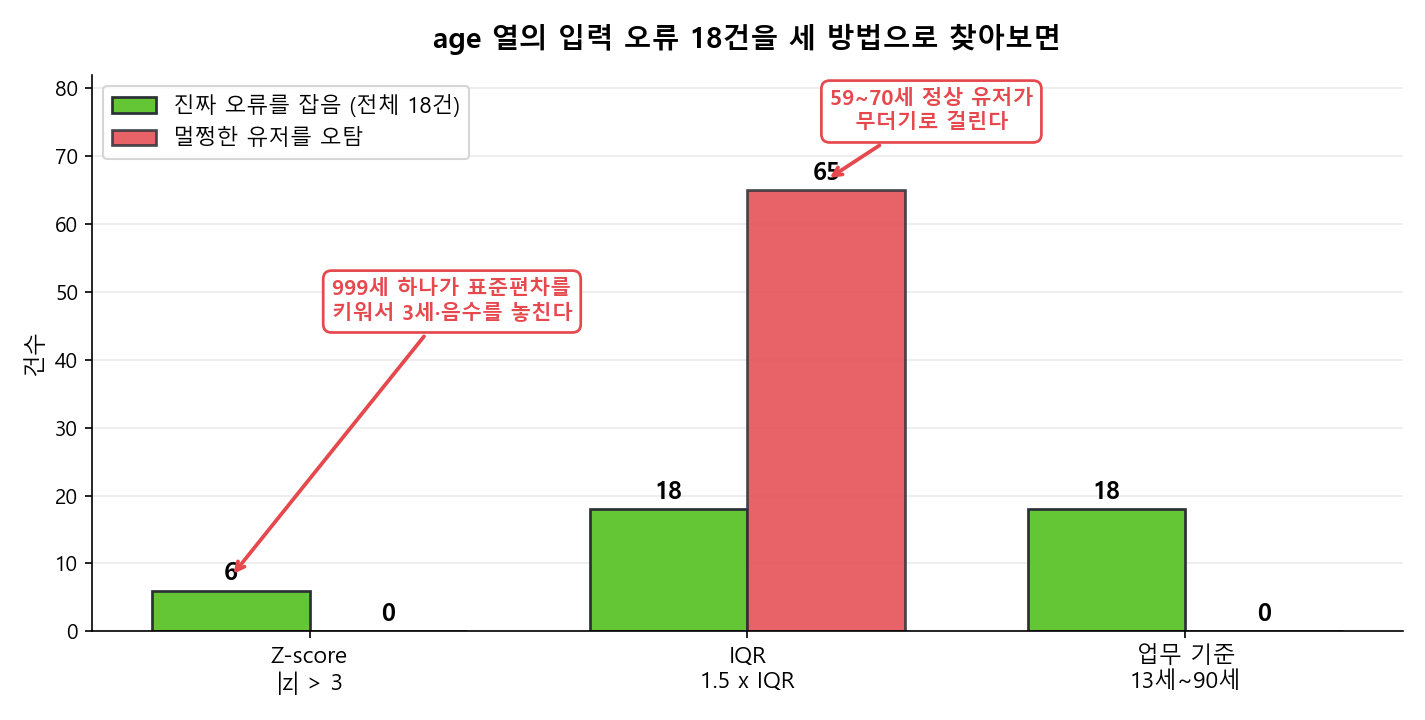
표를 읽는 법은 이렇다.
Z-score — 오탐은 없지만 18건 중 6건만 잡았다. 마스킹 때문에 놓쳤다.
IQR — 18건을 모두 잡았지만 65건을 잘못 잡았다. 59~70세 정상 유저들이다.
업무 기준 — 18건을 정확히 잡고 오탐이 없다.
어떤 통계 기법도 업무 기준을 이기지 못했다. 당연하다. '나이는 13~90세'라는 지식은 데이터 안에 없고 사람의 머릿속에 있기 때문이다. 통계 기법의 역할은 업무 기준을 만들 수 없을 때 후보를 좁히는 것이지, 업무 지식을 대체하는 게 아니다.
방법 | 언제 쓰나 | 약점 |
|---|---|---|
업무 기준 | 값의 가능 범위를 아는 열. 나이, 비율, 날짜 | 도메인 지식이 필요하고 열마다 손으로 정해야 한다 |
IQR 1.5배 | 분포를 모르는 열의 1차 스크리닝 | 치우친 분포에서 정상값을 대량 오탐한다 |
Z-score |z|>3 | 정규분포에 가깝고 극단값이 적은 열 | 마스킹에 취약하다. 이상치가 많으면 무력해진다 |
수정 Z-score | 극단값이 섞인 열의 스크리닝 | MAD가 0이면 계산 불가(0이 절반 넘는 열) |
다변량·모델 기반 | 열 하나로는 안 보이는 이상 조합 | 가정과 오염 비율을 따로 검증해야 한다 |
6단계: 한 열만 봐서는 안 보이는 이상치
지금까지는 열 하나씩만 봤다. 그런데 각 열은 정상인데 조합이 이상한 경우가 있다. 이 데이터에는 매크로 봇 계정 15개가 심어져 있다.
봇의 특징은 이렇다. 플레이타임은 8,000시간이 넘는데 레벨은 20~60에 머문다. 같은 자리에서 반복 사냥만 돌리기 때문이다. 그런데 레벨 40은 흔한 값이고, 플레이타임이 긴 유저도 정상적으로 존재한다. 두 열을 따로 보면 안 잡힌다.
# figure(): 그래프 크기 설정(가로 9인치, 세로 5인치)
plt.figure(figsize=(9, 5))

# scatter(): 산점도 생성
# x축: total_playtime_hours(총 플레이 시간)
# y축: level(레벨)
# s=12: 점 크기 설정
# alpha=0.5: 점의 투명도를 50%로 설정
plt.scatter(
    df["total_playtime_hours"],
    df["level"],
    s=12,
    alpha=0.5
)

# xscale("log"): x축을 로그 스케일(로그 눈금)로 변환
plt.xscale("log")

# xlabel(): x축 이름 설정
plt.xlabel("total_playtime_hours (로그 눈금)")

# ylabel(): y축 이름 설정
plt.ylabel("level")

# show(): 그래프 출력
plt.show()
(그래프 출력)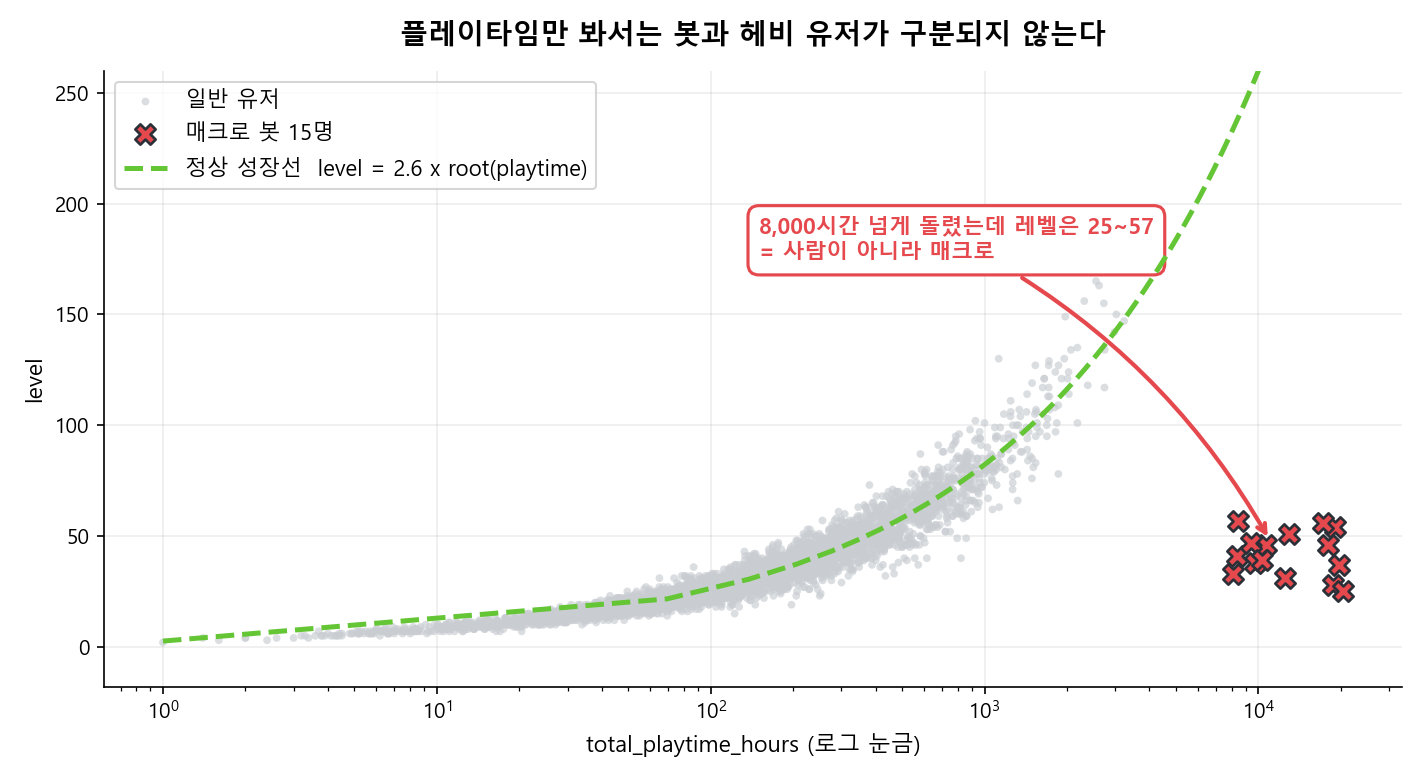
점들이 하나의 곡선을 따라 모여 있는데, 오른쪽 아래에 무리에서 떨어진 X 표시 15개가 보인다. 레벨은 플레이타임의 제곱근에 비례해 자라므로, 이 관계를 비율로 만들면 숫자로 잡을 수 있다.
# 조건 필터링: total_playtime_hours(총 플레이 시간)가 0보다 큰 데이터만 선택
# copy(): 원본 데이터(df)를 변경하지 않도록 복사본 생성
valid = df[df["total_playtime_hours"] > 0].copy()

# np.sqrt(): 총 플레이 시간의 제곱근 계산
# level_per_sqrt: 레벨 ÷ √(총 플레이 시간) 파생변수 생성
valid["level_per_sqrt"] = (
    valid["level"] / np.sqrt(valid["total_playtime_hours"])
)

# describe(): 개수, 평균, 표준편차, 최소값, 사분위수, 최댓값 등 기초통계량 계산
# round(2): 소수 둘째 자리까지 반올림
# print(): 결과 출력
print(valid["level_per_sqrt"].describe().round(2))
count 4024.00
mean 2.59
std 0.38
min 0.17
25% 2.37
50% 2.60
75% 2.84
max 3.87
Name: level_per_sqrt, dtype: float64일반 유저는 2.37~2.84 사이에 몰려 있다. 최솟값 0.17은 명백히 다른 무리다. 1.0을 경계로 잘라 본다.
# 조건 필터링: level_per_sqrt가 1.0 미만인 계정을 의심 계정으로 선택
bots = valid[valid["level_per_sqrt"] < 1.0]

# len(): 의심 계정 수 계산
# print(): 의심 계정 수 출력
print(f"의심 계정: {len(bots)}명")

# [["..."]]: 출력할 열(user_id, 플레이 시간, 레벨, 평균 세션 시간)만 선택
# sort_values(): 총 플레이 시간을 기준으로 내림차순 정렬
# ascending=False: 큰 값부터 정렬
# head(6): 상위 6개 행만 선택
# to_string(index=False): 인덱스 없이 표 형태로 출력
# print(): 결과 출력
print(
    bots[
        ["user_id", "total_playtime_hours", "level", "avg_session_min"]
    ]
    .sort_values("total_playtime_hours", ascending=False)
    .head(6)
    .to_string(index=False)
)
의심 계정: 15명
user_id total_playtime_hours level avg_session_min
U101264 20434.1 25 719.5
U103784 19636.7 37 799.8
U101891 19021.4 54 1018.7
U102902 18773.6 28 623.3
U101720 17988.4 46 1337.5
U101931 17204.1 56 983.2정확히 15명, 심어둔 봇 전부다. 오탐이 하나도 없다. 평균 세션이 600~1,300분(10~22시간)이라는 것도 사람이 아니라는 증거다.
두 열의 관계를 비율이나 잔차로 바꾸면 다변량 이상치가 단변량 문제가 된다. 라이브러리를 꺼내기 전에 이 방법을 먼저 시도해 볼 만하다. 본격적으로 하려면
IsolationForest나LocalOutlierFactor같은 모델 기반 방법이 있다.
7단계: 이상치가 오히려 핵심인 경우
여기가 이 글에서 가장 중요한 부분이다. 지금까지는 '어떻게 찾을까'였다면, 이제는 찾았는데 지우면 안 되는 경우다.
게임마다 ‘정상’의 범위가 다르다
플레이타임 3,000시간짜리 유저를 봤다고 하자. 이상치인가? 질문 자체가 성립하지 않는다. 어떤 게임이냐에 따라 답이 정반대다.
게임 | 열성 유저의 흔한 플레이타임 | 3,000시간의 의미 |
|---|---|---|
문명, 림월드, 팩토리오 | 1,000~5,000시간 | 평범한 팬. 커뮤니티에서는 오히려 적은 편 |
MMORPG (WoW, 파이널판타지14) | 2,000~10,000시간 | 정상적인 장기 구독자 |
모바일 캐주얼 퍼즐 | 50~300시간 | 매우 이례적. 매크로를 의심할 만함 |
스토리 중심 싱글 게임 | 20~100시간 | 거의 확실히 비정상. 켜두고 방치했을 가능성 |
림월드나 문명은 한 판이 수십 시간이고 모드를 얹으면 끝없이 이어진다. 이런 게임에서 '3,000시간 이상은 이상치'라는 규칙을 쓰면 가장 충성도 높은 핵심 고객층을 통째로 분석에서 지우게 된다. 반대로 하이퍼 캐주얼 퍼즐 게임에서 3,000시간이 찍혔다면 매크로이거나 로그 집계 버그다.
같은 숫자, 같은 열, 정반대의 판단이다. 그래서 임계값은 통계가 아니라 그 서비스를 아는 사람이 정해야 한다. 이 데이터에서 봇을 8,000시간으로 자를 수 있었던 것도 '이 게임의 헤비 유저는 최대 3,000시간대'라는 사실을 알고 있었기 때문이다.
실무에서는 이 대화를 반드시 거친다. "이 값이 나올 수 있습니까?" 기획자나 운영팀에 물어보는 5분이 통계 기법 세 개보다 정확하다.
고래 유저를 지우면 매출이 사라진다
결제액은 더 극단적이다. 3단계에서 IQR이 830명을 이상치로 잡았던 그 열이다. IQR 기준을 그대로 적용하면 어떻게 되는지 계산해 본다.
purchase = df["total_purchase_krw"]
lower, upper, n = iqr_outliers(purchase)

print(f"IQR 상한: {upper:,.0f}원, 초과: {n}명")
print()
print(f"{'처리':20s} {'ARPU':>12s} {'전체 매출':>14s}")
print(f"{'원본':20s} {purchase.mean():12,.0f} {purchase.sum():14,.0f}")
print(f"{'IQR 초과 삭제':20s} {purchase[purchase <= upper].mean():12,.0f} "
      f"{purchase[purchase <= upper].sum():14,.0f}")
print(f"{'IQR 상한 클리핑':20s} {purchase.clip(upper=upper).mean():12,.0f} "
      f"{purchase.clip(upper=upper).sum():14,.0f}")
IQR 상한: 6,438원, 초과: 830명
처리 ARPU 전체 매출
원본 35,919 144,751,794
IQR 초과 삭제 288 921,500
IQR 상한 클리핑 1,554 6,264,625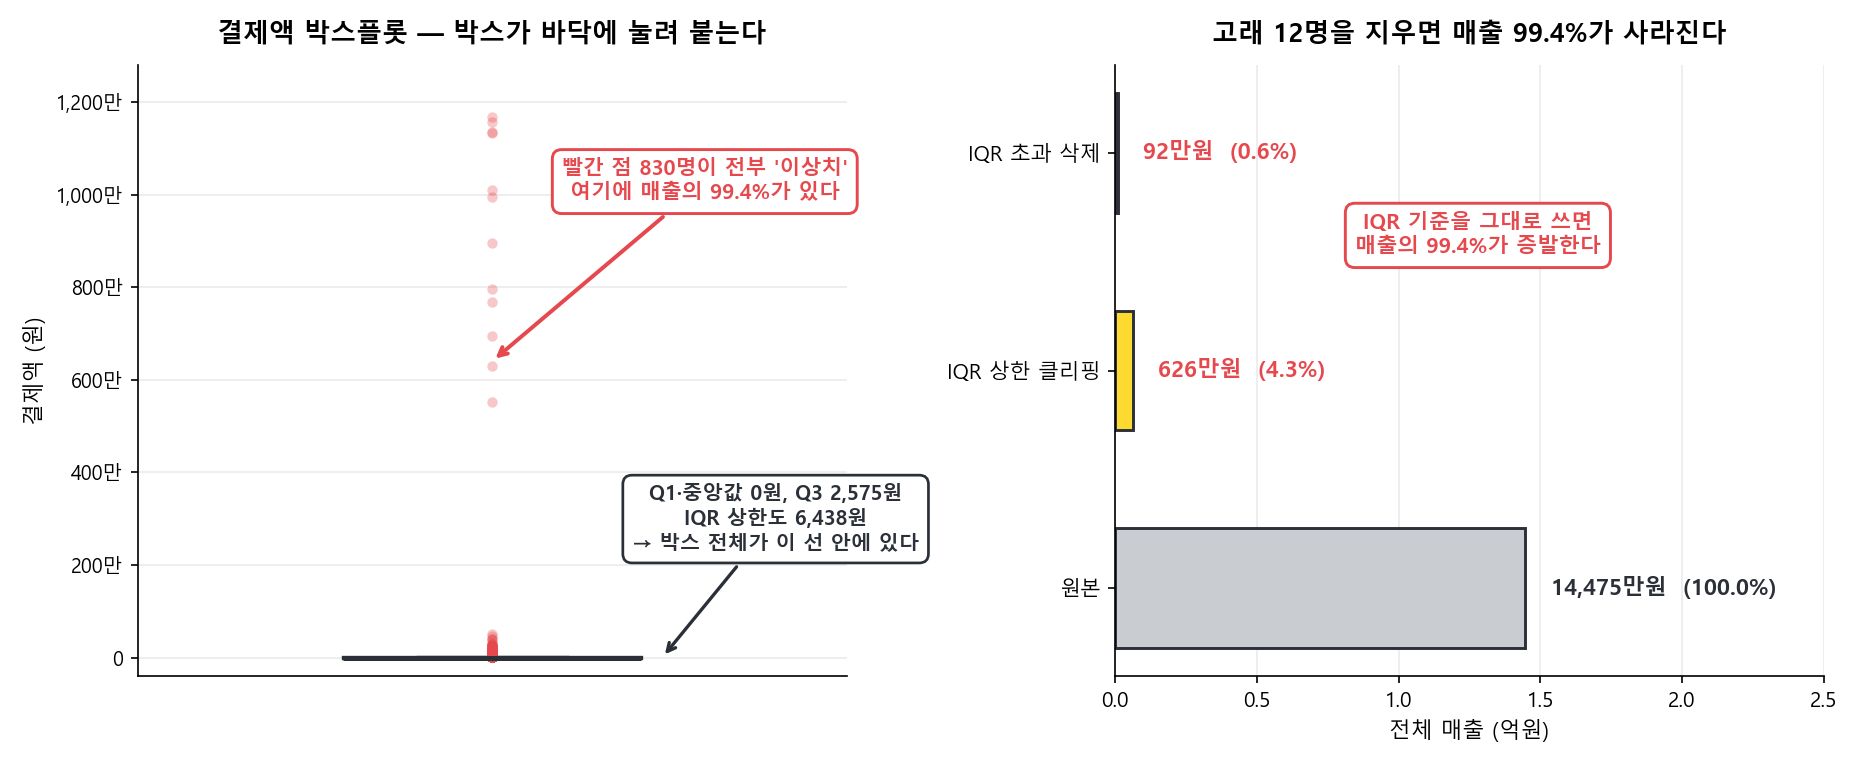
매출 1억 4,475만원이 92만원이 되었다. 99.4%가 증발했다. 클리핑도 별반 다르지 않아 96%가 날아간다.
top12 = purchase.nlargest(12)
print(f"상위 12명의 결제액 합: {top12.sum():,}원")
print(f"전체 매출에서 차지하는 비중: {top12.sum() / purchase.sum() * 100:.1f}%")
상위 12명의 결제액 합: 109,299,794원
전체 매출에서 차지하는 비중: 75.5%4,030명 중 12명이 매출의 75.5%를 만든다. 게임 업계에서 고래(whale)라 부르는 유저들이다. 통계적으로는 완벽한 이상치이고, 사업적으로는 가장 지우면 안 되는 데이터다. 이들을 지운 ARPU 288원을 들고 가면 회의실에서 완전히 틀린 의사결정이 나온다.
같은 논리가 적용되는 경우들이다.
사기 탐지 — 이상 거래가 곧 찾으려는 정답이다. 지우면 학습할 대상이 없어진다
설비 고장 예측 — 센서의 튀는 값이 고장 직전 신호다
의료 진단 — 정상 범위를 벗어난 수치가 질병의 근거다
네트워크 침입 탐지 — 비정상 트래픽 자체가 탐지 목표다
이상치 제거는 목표 변수와 무관한 노이즈일 때만 정당하다. 예측하려는 대상이 이상치 자체라면, 이상치 제거는 정답지를 지우는 행위다.
8단계: 처리 방법 고르기
찾았으면 정해야 한다. 선택지는 다섯 가지이고, 순서대로 검토하는 것이 좋다.
정정 — 원자료를 확인해 올바른 값으로 고친다. 가능하면 언제나 첫 번째 선택이다. 단위 오류(kg↔g)나 자릿수 실수는 대개 복구할 수 있다
삭제 — 명백한 오류이고 복구할 수 없을 때. 전체에서 차지하는 비율이 작아야 한다
결측 처리로 전환 — 값만
NaN으로 바꾸고 행은 살린다. 다른 열의 정보를 버리지 않는다클리핑(윈저화) — 경계값으로 눌러 담는다. 행 수는 유지되지만 꼬리 정보가 압축된다
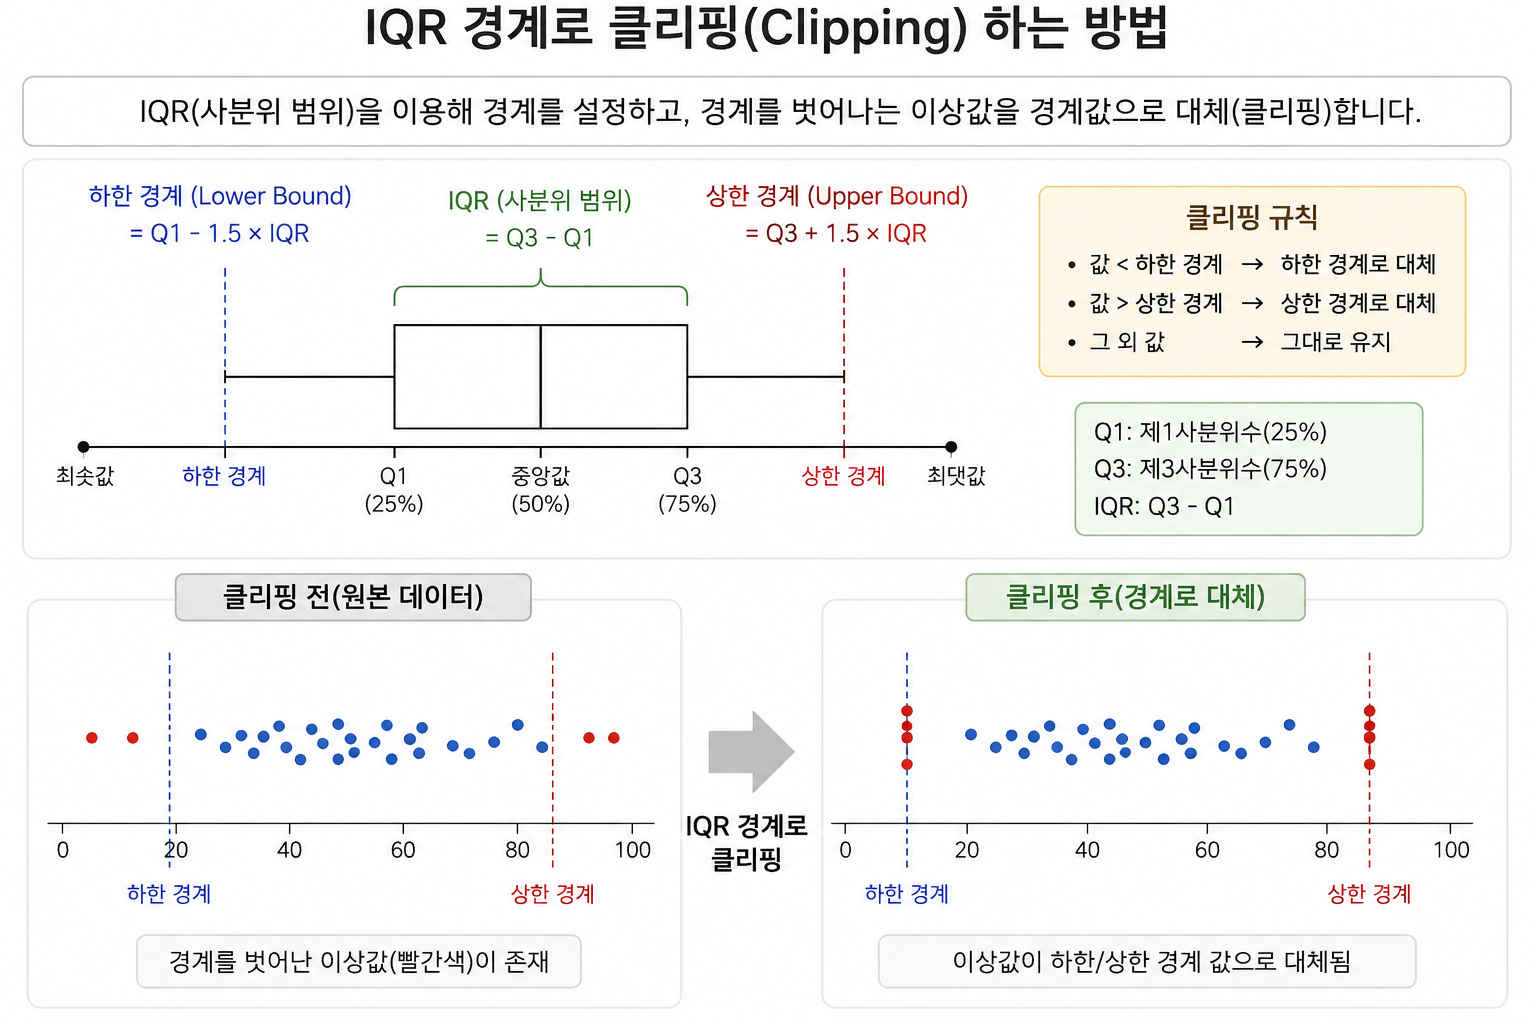
변환·강건 모델 — 값을 그대로 두고 로그를 씌우거나, 이상치에 둔감한 모델을 쓴다
처리 방법에 따라 결과가 얼마나 달라지나
플레이타임 평균을 네 가지 방식으로 계산해 비교한다. 이 데이터는 오류 없는 정답지가 함께 공개되어 있어 채점이 가능하다.
clean = pd.read_csv("https://1000page.pages.dev/data/game-users-clean.csv")
play = df["total_playtime_hours"]
lower, upper, _ = iqr_outliers(play)

print(f"{'아무것도 안 함':20s} {play.mean():7.1f}")
print(f"{'IQR 밖 전부 삭제':20s} {play[(play >= lower) & (play <= upper)].mean():7.1f}")
print(f"{'IQR 경계로 클리핑':20s} {play.clip(lower, upper).mean():7.1f}")
print(f"{'오류·봇만 제거':20s} {play[(play > 0) & (play < 8000)].mean():7.1f}")
print(f"{'진짜 평균 (정답지)':20s} {clean['total_playtime_hours'].mean():7.1f}")
아무것도 안 함 297.9
IQR 밖 전부 삭제 175.3
IQR 경계로 클리핑 216.3
오류·봇만 제거 249.1
진짜 평균 (정답지) 249.1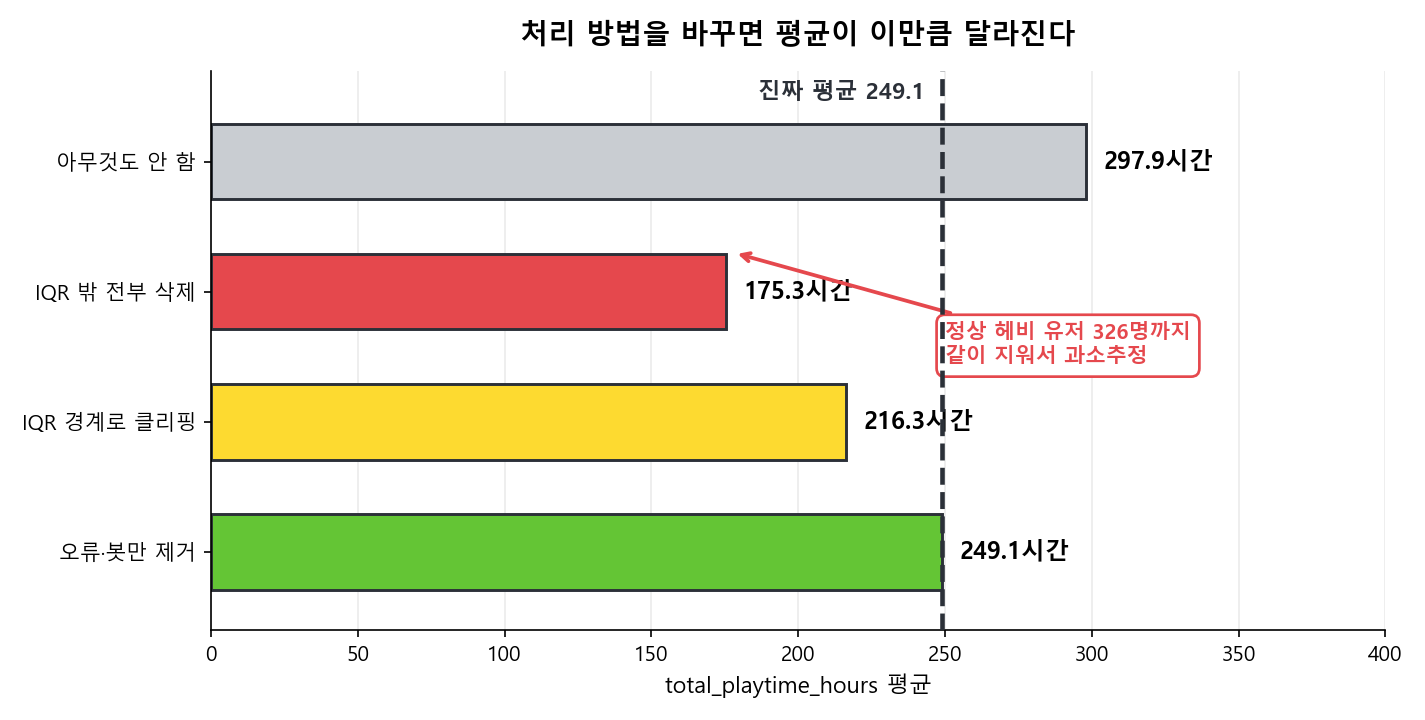
결과가 분명하다.
아무것도 안 하면 297.9시간. 봇 15개가 평균을 49시간이나 끌어올렸다
IQR로 일괄 삭제하면 175.3시간. 정답보다 74시간이나 낮다. 정상 헤비 유저 326명을 함께 지웠기 때문이다
클리핑도 216.3시간으로 여전히 과소추정이다
오류와 봇만 골라 제거하면 249.1시간으로 정답과 정확히 일치한다
정답에 도달한 방법만 통계 기법을 쓰지 않았다. '음수는 집계 버그', '8,000시간은 봇'이라는 판단은 앞 단계에서 업무 기준과 산점도로 확인한 결과다.
값을 살리는 처리 — 로그 변환
삭제도 클리핑도 정보를 버린다. 꼬리가 긴 분포는 변환으로 다루는 편이 나을 때가 많다.
play_positive = play[play > 0]
print(f"원본 왜도      {play_positive.skew():.2f}")
print(f"log1p 후 왜도  {np.log1p(play_positive).skew():.2f}")
원본 왜도 15.67
log1p 후 왜도 -0.14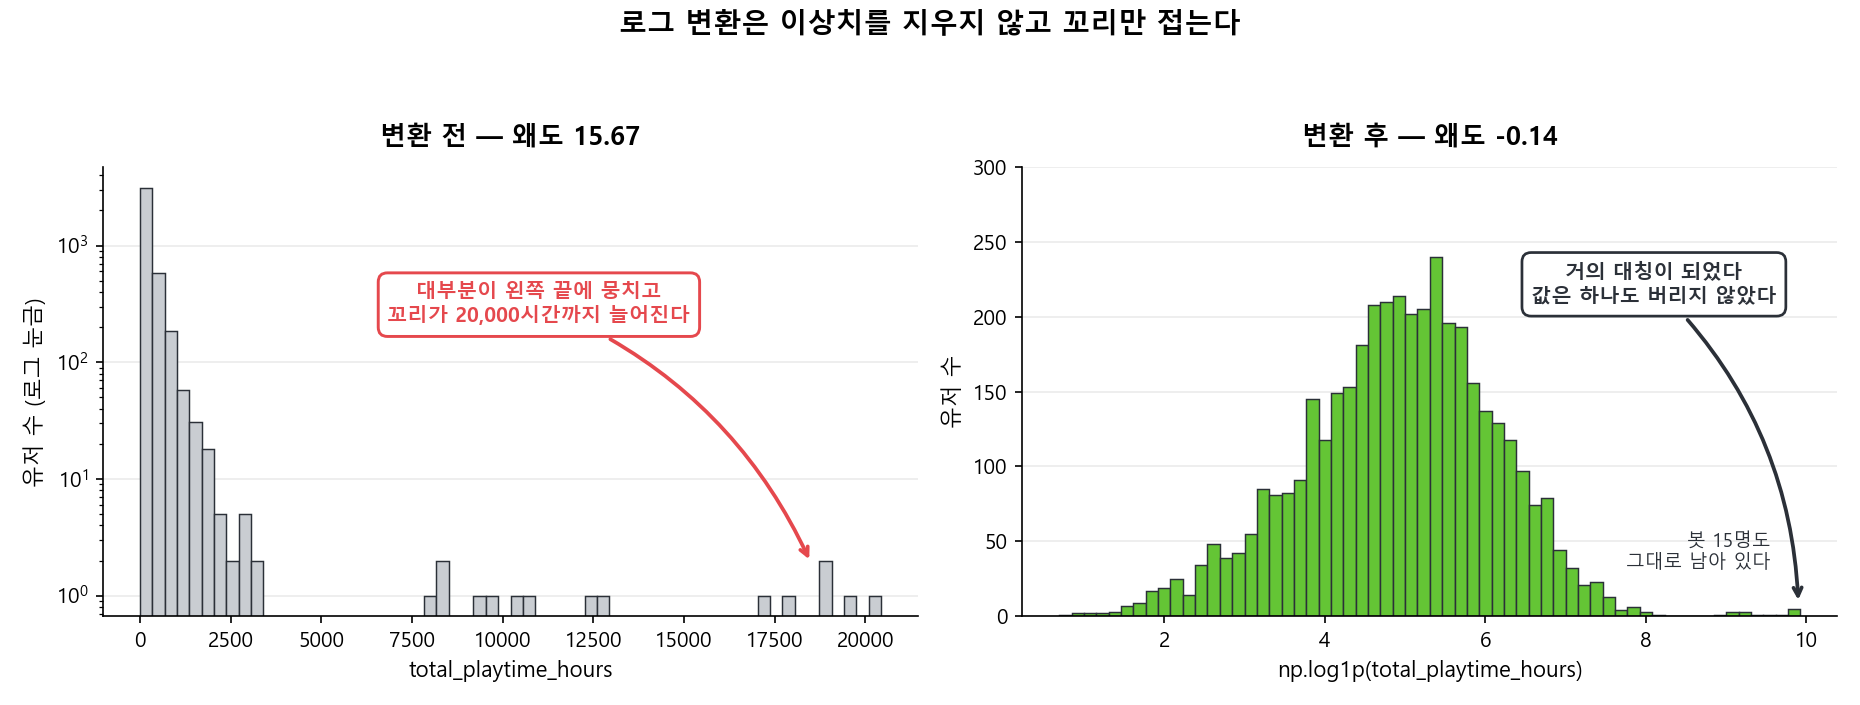
왜도가 15.67에서 -0.14로 떨어졌다. 거의 대칭 분포가 되었다. 값을 하나도 버리지 않고 극단값의 영향만 줄인 것이다. 오른쪽 끝을 보면 봇 15명도 그대로 남아 있다. 삭제나 클리핑과 달리 로그 변환은 이상치를 없애지 않는다. 순서와 개수를 유지한 채 간격만 좁힐 뿐이므로, 선형 회귀처럼 정규성을 가정하는 모델에는 이쪽이 낫다.
np.log1p는log(1+x)를 계산한다. 0이 있어도 안전하다. 되돌릴 때는np.expm1을 쓴다. 음수가 있으면 로그를 못 씌우므로 오류를 먼저 걷어내야 한다.
값을 살리는 처리 — 강건 스케일링과 파생 변수
스케일링 단계에서도 선택지가 있다. StandardScaler는 평균과 표준편차를 쓰므로 이상치에 흔들린다. RobustScaler는 중앙값과 IQR을 쓴다.
from sklearn.preprocessing import StandardScaler, RobustScaler

x = play.values.reshape(-1, 1)
print(f"{'StandardScaler 범위':24s} {StandardScaler().fit_transform(x).max():8.2f}")
print(f"{'RobustScaler 범위':24s} {RobustScaler().fit_transform(x).max():8.2f}")
StandardScaler 범위 22.06
RobustScaler 범위 84.63숫자가 커졌다고 나쁜 게 아니다. RobustScaler는 가운데 50%를 1로 맞추므로 대다수 값이 좁은 범위에 놓이고 극단값만 멀리 남는다. 반면 StandardScaler는 이상치가 표준편차를 키워 정상값들이 0 근처로 뭉개진다.
고래 유저처럼 지우면 안 되는 극단값은 파생 변수로 따로 표시하는 방법도 있다. 값을 살리면서 모델에 신호를 주는 방식이다.
df["is_whale"] = (df["total_purchase_krw"] >= 3_000_000).astype(int)
df["log_purchase"] = np.log1p(df["total_purchase_krw"])

print(df.groupby("is_whale")[["total_purchase_krw", "total_playtime_hours"]].mean().round(1))
total_purchase_krw total_playtime_hours
is_whale
0 8823.3 298.3
1 9108316.2 165.2흥미로운 결과다. 고래 유저의 평균 플레이타임은 165.2시간으로 나머지 유저(298.3시간)보다 오히려 짧다. '많이 결제하는 사람은 오래 하는 사람'이라는 통념과 반대다. 이 12명을 이상치라며 지웠다면 이런 관계는 아예 볼 수 없었을 것이다.
9단계: 경계값은 학습 데이터에서만 구한다
마지막으로 실무에서 자주 놓치는 부분이다. IQR 경계나 클리핑 상한을 전체 데이터로 계산한 뒤 학습/검증을 나누면 검증 데이터의 정보가 학습에 새어 든다. 데이터 누수(leakage)다.
경계 계산을 Pipeline 안에 넣으면 학습 폴드에서만 fit된다.
from sklearn.base import BaseEstimator, TransformerMixin
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import RobustScaler


class IQRClipper(BaseEstimator, TransformerMixin):
    """학습 데이터의 사분위수로만 경계를 정하고, 그 경계를 검증에도 그대로 쓴다."""

    def __init__(self, factor=1.5):
        self.factor = factor

    def fit(self, X, y=None):
        X = pd.DataFrame(X)
        q1, q3 = X.quantile(0.25), X.quantile(0.75)
        iqr = q3 - q1
        self.lower_ = q1 - self.factor * iqr
        self.upper_ = q3 + self.factor * iqr
        return self

    def transform(self, X):
        return pd.DataFrame(X).clip(self.lower_, self.upper_, axis="columns")


features = ["total_playtime_hours", "avg_session_min", "level"]
data = df.dropna(subset=features + ["churn_flag"])
X_train, X_test, y_train, y_test = train_test_split(
    data[features], data["churn_flag"], test_size=0.2, random_state=42, stratify=data["churn_flag"]
)

pipe = Pipeline([
    ("clip", IQRClipper()),
    ("scale", RobustScaler()),
    ("model", LogisticRegression(max_iter=1000)),
])
pipe.fit(X_train, y_train)

print("학습 데이터로 정한 상한:")
print(pipe.named_steps["clip"].upper_.round(1))
print(f"\n테스트 정확도: {pipe.score(X_test, y_test):.3f}")
학습 데이터로 정한 상한:
total_playtime_hours 679.3
avg_session_min 91.4
level 85.0
dtype: float64
테스트 정확도: 0.636상한이 679.3시간으로 잡혔다. 전체 데이터로 계산했던 662.8시간과 다르다. 학습 데이터 80%만 썼기 때문이다. 이 차이가 곧 누수를 막은 결과다. 전체로 계산한 662.8을 썼다면 테스트 데이터의 분포 정보를 이미 훔쳐본 셈이 된다.
교차검증에서도 마찬가지다. 폴드마다 경계가 다시 계산되어야 한다. Pipeline 밖에서 미리 클리핑해 두면 모든 폴드가 같은 경계를 공유하게 되어 검증 점수가 실제보다 좋게 나온다.
정리: 판단 순서
describe()로 최솟값·최댓값을 먼저 본다. 대부분의 입력 오류가 여기서 드러난다업무 기준으로 불가능한 값을 걷어낸다. 통계보다 정확하고 오탐이 없다
남은 것에 IQR이나 수정 Z-score를 걸어 후보를 좁힌다. 일반 Z-score는 마스킹에 취약하다
산점도나 비율 변수로 다변량 이상치를 확인한다. 열 하나로는 안 보이는 조합이 있다
후보마다 "이 값이 나올 수 있는가"를 묻는다. 여기서 오류와 극단값이 갈린다
오류는 정정하거나 삭제하고, 정당한 극단값은 변환·강건 모델·파생 변수로 살린다
경계값 계산은 Pipeline 안에 넣어 학습 데이터에만 fit한다
전체를 관통하는 원칙은 하나다. 이상치 탐지는 삭제 규칙이 아니라 조사 목록을 만드는 단계다. IQR이 표시한 830명은 '지울 830명'이 아니라 '확인할 830명'이다. 그 확인을 건너뛰면 고래 유저 12명과 매출 75%가 함께 사라진다.
전체 코드
위에서 나눠 실행한 코드를 하나로 모았다. 그대로 복사해 실행하면 이 글의 주요 출력을 재현할 수 있다.
import numpy as np
import pandas as pd
from urllib.request import Request, urlopen


def load(url):
    request = Request(url, headers={"User-Agent": "Mozilla/5.0"})
    with urlopen(request, timeout=30) as response:
        return pd.read_csv(response)


def iqr_outliers(s, k=1.5):
    q1, q3 = s.quantile(0.25), s.quantile(0.75)
    iqr = q3 - q1
    lower, upper = q1 - k * iqr, q3 + k * iqr
    return lower, upper, ((s < lower) | (s > upper)).sum()


BASE = "https://1000page.pages.dev/data/"
df = load(BASE + "game-users.csv")
clean = load(BASE + "game-users-clean.csv")

# 1. describe로 냄새 맡기
print("[1] 기초 통계")
cols = ["age", "total_playtime_hours", "avg_session_min", "total_purchase_krw"]
print(df[cols].describe().loc[["count", "mean", "std", "min", "50%", "max"]].round(1))

# 2. 업무 기준 스캔
print("\n[2] 업무 기준 위반")
snapshot = pd.Timestamp("2026-08-01")
checks = {
    "age: 13세 미만/90세 초과": ((df["age"] < 13) | (df["age"] > 90)).sum(),
    "playtime: 음수":         (df["total_playtime_hours"] < 0).sum(),
    "session: 0분":           (df["avg_session_min"] == 0).sum(),
    "signup: 미래 날짜":       (pd.to_datetime(df["signup_date"]) > snapshot).sum(),
}
for name, count in checks.items():
    print(f"  {name:22s} {count:3d}건")

# 3. IQR 일괄 적용
print("\n[3] IQR 이상치")
rows = []
for col in cols:
    s = df[col].dropna()
    lower, upper, n = iqr_outliers(s)
    rows.append([col, round(lower, 1), round(upper, 1), n, round(n / len(s) * 100, 1)])
print(pd.DataFrame(rows, columns=["컬럼", "하한", "상한", "이상치수", "비율(%)"]).to_string(index=False))

# 4. Z-score의 마스킹
print("\n[4] 마스킹")
age = df["age"].dropna()
age2 = age[age < 200]
print(f"  999 포함: std {age.std():6.2f}  z(3세) {(3 - age.mean()) / age.std():6.2f}")
print(f"  999 제외: std {age2.std():6.2f}  z(3세) {(3 - age2.mean()) / age2.std():6.2f}")

# 5. 세 방법 채점
print("\n[5] 방법별 성적")
lower, upper, _ = iqr_outliers(age)
iqr_flag = (age < lower) | (age > upper)
z_flag = ((age - age.mean()) / age.std()).abs() > 3
errors = (age < 13) | (age > 90)
print(pd.DataFrame({
    "방법": ["Z-score |z|>3", "IQR 1.5배", "업무 기준"],
    "탐지": [z_flag.sum(), iqr_flag.sum(), errors.sum()],
    "진짜오류": [(errors & z_flag).sum(), (errors & iqr_flag).sum(), errors.sum()],
    "오탐": [(~errors & z_flag).sum(), (~errors & iqr_flag).sum(), 0],
}).to_string(index=False))

# 6. 다변량 — 봇 탐지
print("\n[6] 매크로 봇")
valid = df[df["total_playtime_hours"] > 0].copy()
valid["level_per_sqrt"] = valid["level"] / np.sqrt(valid["total_playtime_hours"])
print(f"  level/sqrt(playtime) < 1.0 : {(valid['level_per_sqrt'] < 1.0).sum()}명")

# 7. 고래를 지우면
print("\n[7] 결제액 처리별 매출")
purchase = df["total_purchase_krw"]
_, p_upper, _ = iqr_outliers(purchase)
print(f"  원본          {purchase.sum():14,.0f}원")
print(f"  IQR 초과 삭제  {purchase[purchase <= p_upper].sum():14,.0f}원")
print(f"  상위 12명 비중 {purchase.nlargest(12).sum() / purchase.sum() * 100:.1f}%")

# 8. 처리 방법별 평균
print("\n[8] 플레이타임 평균 비교")
play = df["total_playtime_hours"]
lo, hi, _ = iqr_outliers(play)
print(f"  아무것도 안 함     {play.mean():7.1f}")
print(f"  IQR 밖 전부 삭제   {play[(play >= lo) & (play <= hi)].mean():7.1f}")
print(f"  IQR 경계로 클리핑   {play.clip(lo, hi).mean():7.1f}")
print(f"  오류·봇만 제거     {play[(play > 0) & (play < 8000)].mean():7.1f}")
print(f"  진짜 평균         {clean['total_playtime_hours'].mean():7.1f}")
그래프에 한글이 네모로 깨지면 폰트 설정이 빠진 것이다. Windows는
Malgun Gothic, macOS는AppleGothic, 코랩에서는 나눔폰트를 설치한 뒤NanumBarunGothic을 지정한다. 음수 부호가 깨지면plt.rcParams["axes.unicode_minus"] = False를 함께 준다.
예제 데이터에 대하여
이 글에 쓴 데이터는 학습용으로 직접 만든 가상 데이터다. 실제 게임사 기록이 아니다. 지워야 할 오류와 지우면 안 되는 극단값을 의도적으로 섞어 두었다.
구분 | 건수 | 내용 |
|---|---|---|
고래 유저 (정당) | 12명 | 결제액 300만~1,200만원. 전체 매출의 75.5% |
매크로 봇 (정당하나 제외 대상) | 15명 | 플레이타임 8,000~21,000시간에 레벨 20~60 |
나이 입력 오류 | 18건 | 2~5세, 120세, 999세, 음수(-36~-4세) |
세션 0분 | 40건 | 접속 직후 튕긴 로그 |
음수 플레이타임 | 6건 | 집계 버그 |
미래 가입일 | 3건 | 서버 시간 오류 |
생성 스크립트는 시드가 고정되어 있어 몇 번을 실행해도 같은 파일이 나온다. 결측치까지 포함한 전체 설명은 데이터셋 설명 문서에 있다.
참고 자료
NIST/SEMATECH e-Handbook: Box Plot (2026-08-06 확인)
NIST/SEMATECH e-Handbook: Detection of Outliers (2026-08-06 확인)
scikit-learn RobustScaler 공식 문서 (2026-08-06 확인)
scikit-learn 이상치 탐지 사용자 가이드 (2026-08-06 확인)
pandas quantile 공식 문서 (2026-08-06 확인)
댓글 0
댓글을 불러오는 중…