22편부터 여기까지 pytest·Ruff·동시성·Pandas·시각화·통계·sklearn·자동화·프로젝트 구조를 하나씩 따로 다뤘다. 이번 편에서는 이 도구들을 한 데이터에 순서대로 적용해, 수집부터 모델 저장까지 실제로 동작하는 프로젝트 하나를 완성한다.
프로젝트 목표
서울의 실제 최고기온(Open-Meteo API)과 30일치 합성 주문 데이터를 결합해 기온이 식품 카테고리 매출에 영향을 주는가 를 확인하고, 지역·카테고리·기온으로 주문 금액을 예측하는 모델까지 만든다. 프로젝트 폴더는 32편의 구조를 그대로 따른다.
order-analysis/
├── data/
│   ├── raw/
│   │   ├── weather.json      # Open-Meteo 응답 원본
│   │   └── orders_raw.csv    # 정제 전 주문 데이터
│   └── processed/
│       └── orders_clean.csv
├── src/
│   ├── __init__.py
│   ├── schema.py             # Pydantic 검증 모델
│   └── clean.py              # 정제 함수
├── tests/
│   └── test_clean.py
├── templates/
│   └── report.html
├── output/
│   ├── eda_charts.png
│   ├── order_amount_model.pkl
│   └── report.html
└── requirements.txt
1단계 수집 — httpx로 외부 API 호출
25편에서 다룬 방식대로 httpx 로 최근 30일 서울 최고기온을 가져온다. 요청이 하나뿐이라 여기서는 동기 호출로 충분하지만, 여러 도시를 동시에 모은다면 asyncio.gather 로 확장한다(25편 참고).
import httpx

r = httpx.get(
    "https://api.open-meteo.com/v1/forecast",
    params={
        "latitude": 37.5665, "longitude": 126.9780,
        "daily": "temperature_2m_max",
        "past_days": 30, "forecast_days": 0,
        "timezone": "Asia/Seoul",
    },
    timeout=10,
)
weather = r.json()
200, 30일치 데이터 수신 (2026-07-11 ~ 2026-08-09, 최고기온 25.0~35.7도)이 날씨 데이터에 지역·카테고리별 합성 주문 587건을 날짜 기준으로 붙여 data/raw/orders_raw.csv 를 만든다. visits 열에는 결측치 20건을 의도적으로 섞었다.
2단계 검증 — Pydantic으로 스키마 확인
21편에서 다룬 방식대로, 수집한 각 행이 기대하는 형태와 범위를 만족하는지 모델로 검증한다.
from pydantic import BaseModel, Field
from typing import Optional

class OrderRecord(BaseModel):
    order_id: int
    date: str
    region: str
    category: str
    visits: Optional[float] = None
    discount_rate: float = Field(ge=0, le=1)
    temp_max: float
    amount: float = Field(gt=0)
ok, errors = [], []
for row in rows:
try:
ok.append(OrderRecord(**row))
except ValidationError as e:
errors.append((row, str(e)))
print(f"검증 통과: {len(ok)} / {len(rows)}, 오류: {len(errors)}")검증 통과: 587 / 587, 오류: 0discount_rate 에 ge=0, le=1 범위를 걸어뒀기 때문에, 수집 단계에서 음수나 100%를 넘는 값이 섞여 들어와도 이 지점에서 걸러진다.
3단계 정제 — 결측치와 이상치 처리
26편에서 다룬 방식으로 결측 보완과 IQR 이상치 제거를 함수 하나로 묶는다. 32편의 원칙대로 이 함수는 노트북이 아니라 src/clean.py 에 둬서 재사용하고 테스트한다.
import pandas as pd

def clean_orders(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()
    df["visits"] = df["visits"].fillna(df["visits"].median())
    Q1, Q3 = df["amount"].quantile([0.25, 0.75])
    IQR = Q3 - Q1
    lo, hi = Q1 - 1.5 * IQR, Q3 + 1.5 * IQR
    return df[df["amount"].between(lo, hi)].reset_index(drop=True)
원본 587행 -> 결측 보완 후 587행 -> 이상치 제거 후 587행이번 데이터에는 극단적인 이상치가 없어 행이 그대로 587건 남았다. 이상치 제거는 항상 행이 줄어야 하는 단계가 아니라, 있으면 걸러내는 안전장치 라는 점을 이 결과가 보여준다.
4단계 테스트 — pytest로 정제 함수 검증
22편에서 다룬 fixture와 예외 케이스 설계를 그대로 적용한다. 이번에는 정상 데이터가 아니라 결측·이상치가 확실히 섞인 작은 표본으로 함수가 실제로 동작하는지 확인한다.
@pytest.fixture
def sample_df():
    return pd.DataFrame({
        "visits": [1, None, 3, 4],
        "amount": [10000, 11000, 9000, 100000],  # 마지막 행은 이상치
    })

def test_clean_orders_fills_missing_visits(sample_df):
    result = clean_orders(sample_df)
    assert result["visits"].isna().sum() == 0

def test_clean_orders_removes_outlier(sample_df):
    result = clean_orders(sample_df)
    assert 100000 not in result["amount"].values
tests/test_clean.py::test_clean_orders_fills_missing_visits PASSED [ 50%]
tests/test_clean.py::test_clean_orders_removes_outlier PASSED [100%]
======================== 2 passed in 0.16s ========================실제 데이터에서는 이상치가 안 걸러졌지만, 이 테스트 덕분에 함수 자체는 이상치를 걸러내는 로직이 맞다는 것을 별도로 확인했다. 커밋 전에는 23편에서 다룬 ruff check 로 코드 스타일까지 함께 검사한다.
5단계 탐색과 시각화
28편에서 다룬 Seaborn으로 기온과 매출의 관계, 지역별 매출 순위를 확인한다.
fig, axes = plt.subplots(1, 2, figsize=(10, 4.2))

food = df[df["category"] == "식품"]
sns.scatterplot(data=food, x="temp_max", y="amount", ax=axes[0], alpha=0.5)
sns.regplot(data=food, x="temp_max", y="amount", ax=axes[0], scatter=False, color="red")
axes[0].set_title("최고기온 vs 식품 카테고리 매출")

by_region = df.groupby("region")["amount"].sum().sort_values(ascending=False)
axes[1].bar(by_region.index, by_region.values)
axes[1].set_title("지역별 총매출")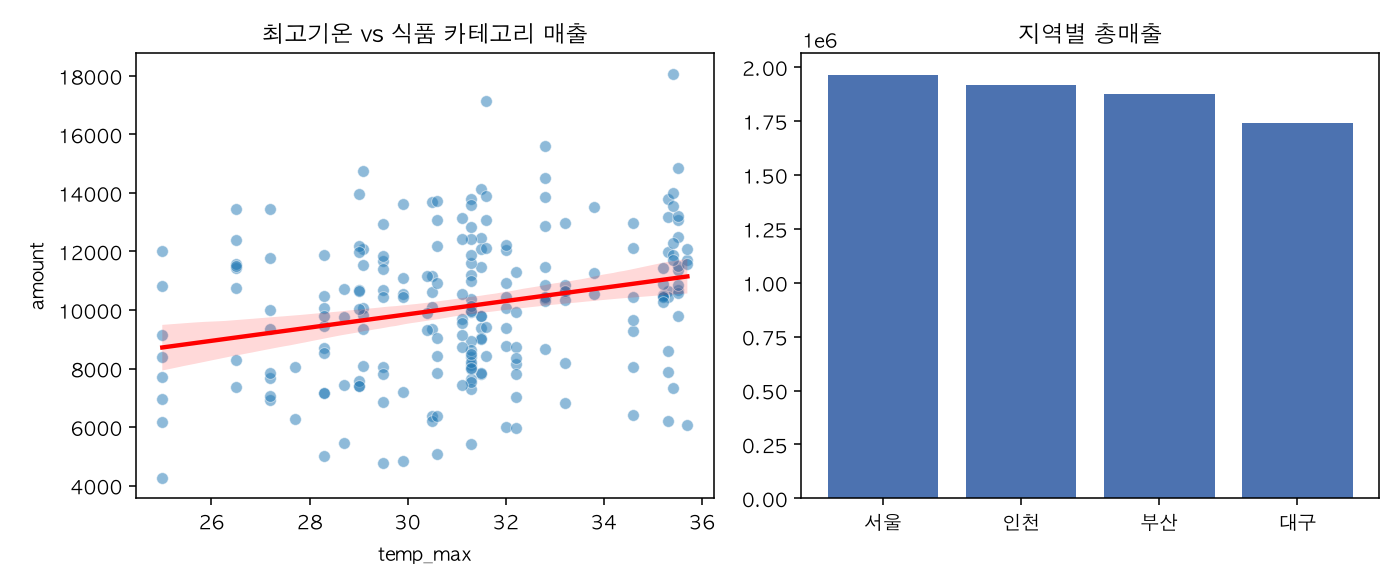
왼쪽 그래프의 회귀선이 오른쪽 위로 기울어 있다 — 기온이 높을수록 식품 매출이 늘어나는 경향이 눈에 보인다. 다음 단계에서 이 경향이 우연인지 검정한다.
6단계 통계 검정 — 더운 날과 선선한 날의 차이
29편에서 다룬 t-test로 "더운 날(기온 중앙값 이상)과 선선한 날의 식품 매출 평균이 실제로 다른가"를 검정한다.
hot = food[food["temp_max"] >= food["temp_max"].median()]["amount"]
cool = food[food["temp_max"] < food["temp_max"].median()]["amount"]
t, p = stats.ttest_ind(hot, cool, equal_var=False)
더운 날 평균: 10,561원 (119건)
선선한 날 평균: 9,589원 (99건)
t=2.999, p=0.0030p-value(0.0030)가 0.05보다 훨씬 작아 두 평균이 같다는 귀무가설을 기각한다. 더운 날의 식품 매출이 선선한 날보다 약 10% 높고, 이 차이는 우연으로 보기 어렵다.
7단계 모델 — sklearn Pipeline으로 매출 예측
30편에서 다룬 ColumnTransformer + Pipeline 으로 지역·카테고리·방문 횟수·할인율·기온으로 주문 금액을 예측하는 회귀 모델을 만든다.
num_cols = ["visits", "discount_rate", "temp_max"]
cat_cols = ["region", "category"]

preproc = ColumnTransformer([
    ("num", StandardScaler(), num_cols),
    ("cat", OneHotEncoder(handle_unknown="ignore"), cat_cols),
])
model = Pipeline([("prep", preproc), ("reg", Ridge(alpha=1.0))])
model.fit(X_train, y_train)

r2 = model.score(X_test, y_test)
mae = mean_absolute_error(y_test, model.predict(X_test))
R2: 0.928, MAE: 919.0이전 26~29편의 결측 보완·이상치 제거·상관 확인을 거친 데이터로 학습했기 때문에, 특별한 튜닝 없이도 결정계수 0.928이라는 준수한 설명력이 나왔다. joblib으로 저장해 재사용 가능한 파일로 남긴다.
joblib.dump(model, "output/order_amount_model.pkl")8단계 리포트 — Jinja2로 결과 문서화
31편에서 다룬 Jinja2로 지금까지의 결과를 HTML 리포트 하나로 묶는다. 외부에서 온 값이 섞일 수 있으므로 autoescape 를 켠다.
env = Environment(loader=FileSystemLoader("templates"), autoescape=select_autoescape())
tmpl = env.get_template("report.html")
html = tmpl.render(
    title="7월 주문 데이터 종합 리포트",
    n_days=30, n_orders=len(df), by_region=by_region,
    hot_mean=10561, cool_mean=9589, t_stat=2.999, p_value=0.00304,
    r2=0.928, mae=919.0,
)
Path("output/report.html").write_text(html, encoding="utf-8")<h1>7월 주문 데이터 종합 리포트</h1>
<p>생성 시각: 2026-08-10 12:32 | 대상 기간: 30일 · 587건</p>
<h2>지역별 매출</h2>
<li>서울: 1,965,015원</li>
<li>인천: 1,917,674원</li>
<li>부산: 1,873,902원</li>
<li>대구: 1,741,985원</li>
<h2>통계 검정</h2>
<p>더운 날 식품 매출 평균 10,561원 vs 선선한 날 9,589원 (t=2.999, p=0.0030)</p>
<p style="color:red">통계적으로 유의미한 차이입니다.</p>
<h2>예측 모델</h2>
<p>R² = 0.928, MAE = 919원</p>이 파일 하나로 수집부터 모델 평가까지 전체 결과를 팀에 공유할 수 있다. 매일 새 데이터로 이 스크립트 전체를 다시 실행하도록 32편의 schedule 예약을 걸면, 리포트가 사람 개입 없이 매일 갱신된다.
이번 실습에서 이어 붙인 이전 편들
단계 | 사용한 도구 | 관련 편 |
|---|---|---|
수집 |
| 25편 |
검증 |
| 21편 |
정제 |
| 26편 |
테스트 |
| 22편 |
코드 품질 |
| 23편 |
시각화 |
| 28편 |
통계 검정 |
| 29편 |
모델 |
| 30편 |
리포트·자동화 |
| 31편 |
프로젝트 구조 | 폴더 배치·README | 32편 |
장점과 한계
구분 | 내용 |
|---|---|
장점 | 각 단계가 이전 편에서 검증한 독립 함수라서, 전체를 새로 짜지 않고 이미 만든 조각을 순서대로 연결하기만 하면 됐다. |
한계 | 실습 규모(587건, 30일)는 작아서 모든 단계가 몇 초 안에 끝난다. 데이터가 수백만 행으로 커지면 3단계는 27편의 Polars·DuckDB로, 7단계의 학습 시간은 별도로 관리해야 한다. |
자주 발생하는 문제
단계 사이에 형식이 안 맞는다. 정제 단계는 date 를 문자열로 다루고 모델 단계는 이를 그대로 범주로 다뤘다. 단계를 넘길 때마다 다음 단계가 기대하는 타입을 한 번씩 확인한다 — 특히 날짜·범주형처럼 여러 표현이 가능한 열에서 자주 어긋난다.
전체를 한 파일에 다 쓴다. 이 실습처럼 8단계를 노트북 한 칸에 몰아 쓰면 다음에 다시 실행하기 어렵다. 실제 프로젝트라면 32편의 구조대로 src/collect.py, src/clean.py, src/model.py 처럼 단계별 모듈로 나누고, run_pipeline.py 하나가 그 모듈들을 순서대로 호출하게 만든다.
관련 문서
이 실습은 시리즈 전체를 전제로 한다. 특히 CRISP-DM과 sklearn Pipeline, Python으로 데이터 분석 리포트 자동화하기, 재현 가능한 데이터 분석 프로젝트 구조 세 편이 이 실습의 뼈대를 이룬다.
참고 자료
Open-Meteo 공식 문서 — Historical Forecast API (2026-08-10 확인)
scikit-learn 공식 문서 — Pipelines and composite estimators (2026-08-10 확인)
댓글 0
댓글을 불러오는 중…