표 하나로 요약한 통계는 데이터를 속일 수 있다. 평균·분산·상관계수가 완전히 같은 네 데이터셋이 있다면, 이 값들만 보고는 네 데이터가 똑같다고 믿기 쉽다. 그림으로 그려보기 전까지는.
한 줄 정의
데이터 시각화 도구는 각자 강점이 다르다. Matplotlib 은 모든 요소를 세밀하게 제어하는 저수준 라이브러리, Seaborn 은 통계적 관계를 적은 코드로 그리는 고수준 라이브러리, Plotly 는 확대·호버가 되는 인터랙티브 차트를, Altair 는 데이터 구조를 선언하면 차트가 완성되는 문법을 제공한다.
왜 숫자만으로는 부족한가 — Anscombe의 사중주
1973년 통계학자 프랭크 앤스컴이 만든 네 데이터셋은 평균·분산·상관계수·회귀선까지 거의 똑같다.
데이터셋 | x 평균 | y 평균 | x 표준편차 | y 표준편차 | 상관계수 |
|---|---|---|---|---|---|
I | 9.00 | 7.50 | 3.32 | 2.03 | 0.816 |
II | 9.00 | 7.50 | 3.32 | 2.03 | 0.816 |
III | 9.00 | 7.50 | 3.32 | 2.03 | 0.816 |
IV | 9.00 | 7.50 | 3.32 | 2.03 | 0.817 |
표만 보면 네 데이터가 사실상 같다고 판단하기 쉽다. 산점도로 그려보면 이야기가 완전히 달라진다.
import seaborn as sns

df = sns.load_dataset("anscombe")
sns.lmplot(data=df, x="x", y="y", col="dataset", hue="dataset", ci=None)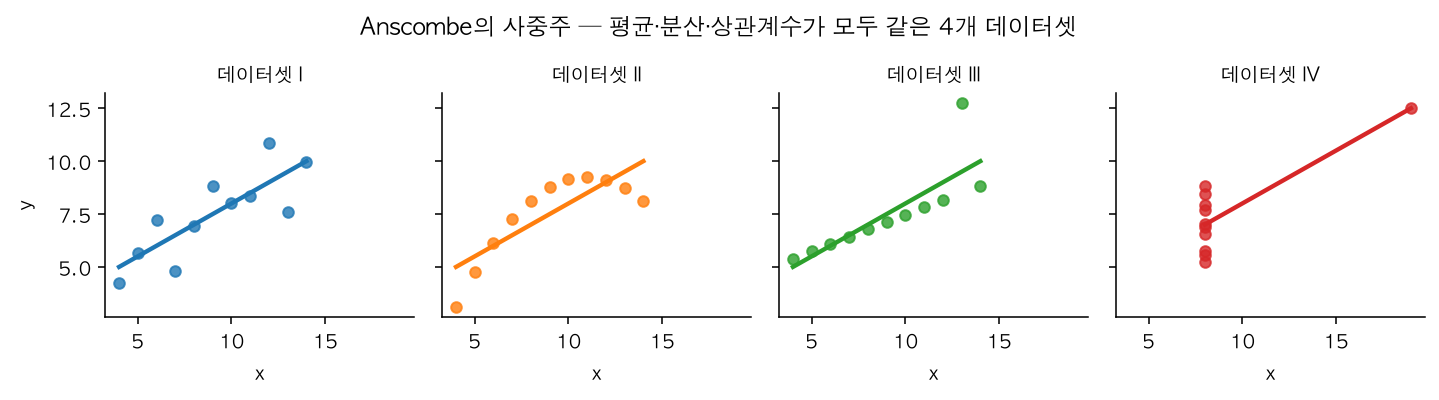
네 데이터셋 모두 회귀선의 기울기와 절편이 거의 같지만, 실제 모양은 직선형(I), 곡선형(II), 이상치가 기울기를 왜곡한 경우(III), 점 하나가 상관관계 전체를 만드는 경우(IV)로 전혀 다르다. 요약 통계만 보고 모델을 골랐다면 셋 다 놓쳤을 문제다.
Matplotlib — 모든 것을 직접 제어한다
Matplotlib의 그림은 두 계층으로 이뤄진다.
구성 요소 | 역할 |
|---|---|
Figure | 전체 캔버스. 하나의 Figure 안에 여러 Axes를 담고, 크기·해상도 같은 속성을 관리한다. |
Axes | 실제 데이터가 그려지는 하나의 플롯. x축·y축·눈금·제목 등 그래프 구성 요소를 담는다. 복수형처럼 보이지만 '축들이 있는 공간' 하나를 가리키는 단수 객체다. |
Figure 하나에 Axes 두 개를 만들어 지역별 매출 막대그래프와 매출 분포 히스토그램을 나란히 그린다.
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(10, 4.2))

by_region = df.groupby("region")["amount"].sum().sort_values(ascending=False)
axes[0].bar(by_region.index, by_region.values)
axes[0].set_title("지역별 총매출")

axes[1].hist(df["amount"], bins=20)
axes[1].set_title("amount 분포")

plt.tight_layout()
plt.savefig("matplotlib_demo.png", dpi=140)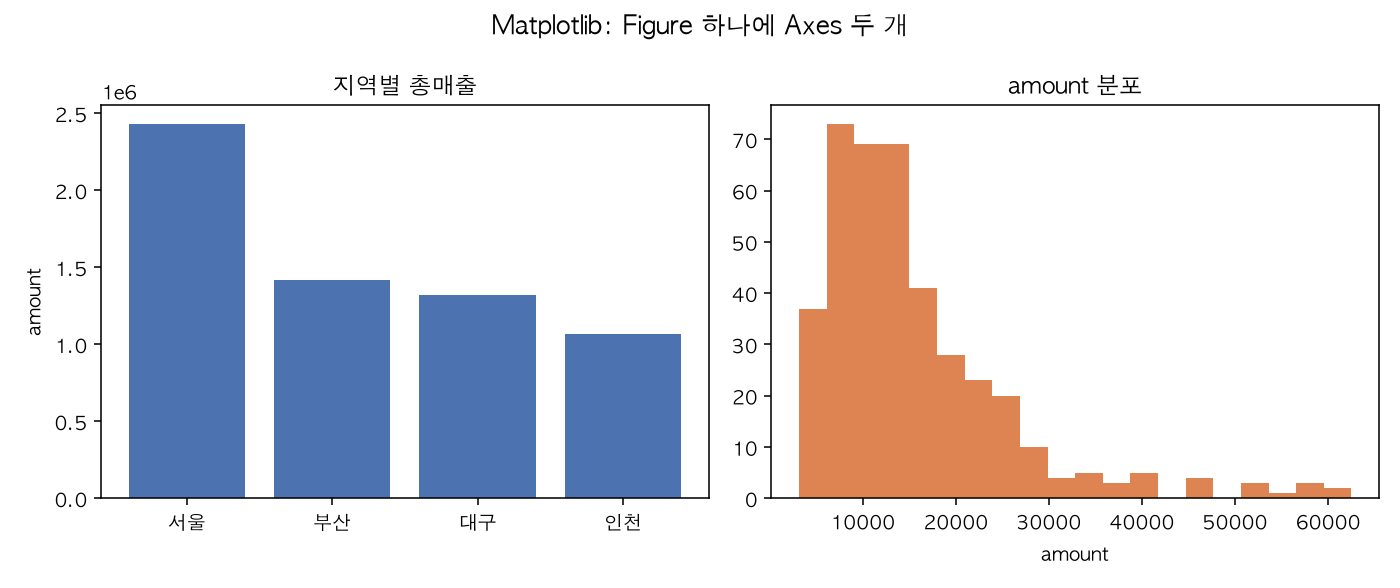
막대 색, 제목 위치, 축 눈금까지 코드 한 줄 한 줄이 그림의 한 요소에 대응한다. 이 저수준 제어가 Matplotlib의 강점이자 코드가 길어지는 이유이기도 하다. Seaborn을 포함해 대부분의 Python 시각화 라이브러리가 내부적으로 Matplotlib을 그리기 엔진으로 쓴다.
Seaborn — 통계적 관계를 적은 코드로
Seaborn은 Matplotlib 위에 놓인 고수준 인터페이스다. hue 인자 하나로 색을 나눠 다차원 정보를 표현하는 패턴이 자주 쓰인다.
import seaborn as sns

fig, axes = plt.subplots(1, 2, figsize=(10, 4.2))

corr = df[["amount", "visits", "discount_rate"]].corr()
sns.heatmap(corr, annot=True, cmap="coolwarm", fmt=".2f", ax=axes[0])

sns.boxplot(data=df, x="region", y="amount", hue="category", ax=axes[1])

plt.tight_layout()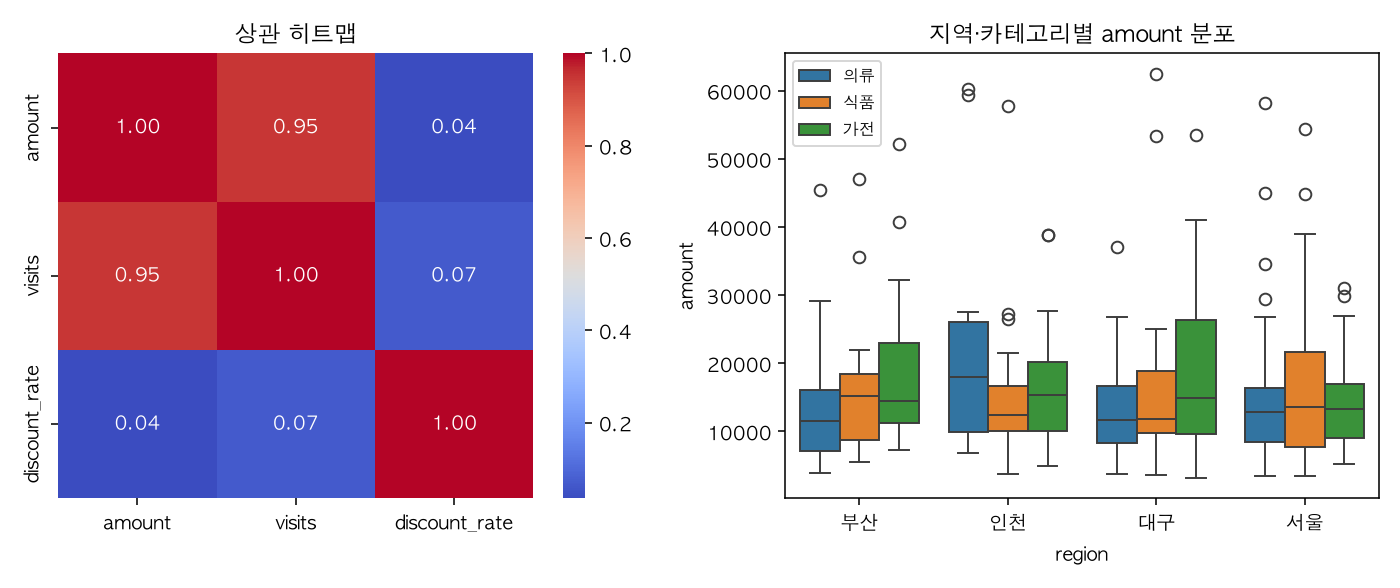
같은 정보를 Matplotlib만으로 그리려면 상관계수를 직접 계산해 텍스트로 넣고, 각 그룹의 사분위수를 손으로 구해야 한다. Seaborn은 이 통계 계산과 배치를 함수 하나에 담아, 짧은 코드로 분포·상관·그룹 비교를 표현한다.
Plotly Express — 인터랙티브 공유
Plotly Express로 만든 차트는 정적 이미지가 아니라 HTML이다. 마우스로 확대·필터·호버가 되는 채로 파일 하나에 담겨, 비전공자에게 발표할 때 특히 효과적이다.
import plotly.express as px

monthly = df.groupby(["region", "category"], as_index=False)["amount"].sum()
fig = px.bar(monthly, x="region", y="amount", color="category",
             title="지역·카테고리별 매출")
fig.write_html("report.html")
write_html 은 기본적으로 렌더링에 필요한 Plotly.js 전체를 파일 안에 그대로 넣는다. 차트 하나만 담긴 파일이 수 MB까지 커지는 이유다.
fig.write_html("report.html")                          # 4.86MB
fig.write_html("report.html", include_plotlyjs="cdn")  # 9.3KB
include_plotlyjs="cdn" 를 주면 라이브러리는 인터넷에서 불러오고 파일에는 데이터와 설정만 남아 크기가 500분의 1 수준으로 줄어든다. 다만 이 옵션을 쓰면 인터넷 연결이 없는 환경에서는 차트가 뜨지 않는다 — 오프라인 배포용 파일에는 기본값(전체 포함)을 쓴다.
Altair — 선언형 문법으로 빠르게
Altair는 Grammar of Graphics 를 따른다. "이 데이터를, 이 좌표에, 이 색으로, 이 모양으로 그려라" 를 선언하면 나머지는 라이브러리가 알아서 계산한다.
import altair as alt

chart = (
    alt.Chart(df)
    .mark_point()
    .encode(
        x="amount:Q",       # Q = 수치형(Quantitative)
        y="region:N",       # N = 명목형(Nominal)
        color="category:N",
        tooltip=["region", "category", "amount"],
    )
    .interactive()
)
chart.save("chart.html")
mark_point() 를 mark_bar() 나 mark_line() 으로 바꾸는 것만으로 같은 데이터를 다른 차트 형태로 그릴 수 있어, 탐색 단계에서 여러 형태를 빠르게 시도해 볼 때 유리하다. Plotly와 달리 기본 저장 방식이 라이브러리를 CDN에서 불러오는 방식이라, 같은 인터랙티브 차트인데도 파일 크기가 수십 KB 수준으로 작다.
도구 선택 기준
상황 | 선택 |
|---|---|
학술 논문·보고서에 넣을 정적 차트, 세부 요소까지 통제해야 한다 |
|
분포·상관관계·그룹 비교를 적은 코드로 빠르게 그린다 |
|
의사결정자에게 확대·필터가 되는 차트를 공유한다 |
|
EDA 단계에서 여러 차트 형태를 빠르게 시도한다 |
|
네 도구를 하나만 골라 쓸 필요는 없다. 탐색 단계에서는 Altair나 Seaborn으로 빠르게 훑고, 보고서에 넣을 최종 차트는 Matplotlib으로 다듬고, 발표 자리에는 Plotly로 인터랙티브 버전을 따로 준비하는 조합이 흔하다.
장점과 한계
구분 | 내용 |
|---|---|
장점 | 네 도구 모두 Pandas DataFrame을 그대로 입력으로 받아 별도 변환이 거의 필요 없고, 상황에 맞게 조합하면 탐색부터 발표까지 한 흐름으로 이어진다. |
한계 | Matplotlib은 간단한 차트도 코드가 길어지고, Plotly·Altair의 인터랙션은 정적 이미지(PDF·인쇄물)에는 담기지 않는다. 도구가 늘어날수록 팀 안에서 문법을 통일하는 비용도 함께 는다. |
자주 발생하는 문제
한글이 네모(□)로 보인다. Matplotlib 기본 폰트는 한글 글리프가 없다. 시스템에 설치된 한글 폰트로 지정해야 한다.
plt.rcParams["font.family"] = "AppleGothic"   # 윈도우는 "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False    # 마이너스 기호 깨짐 방지
Plotly HTML 파일을 통째로 이메일에 첨부해 용량 문제를 겪는다. 위에서 본 것처럼 기본 저장은 라이브러리 전체를 포함한다. 인터넷이 되는 환경으로 공유한다면 include_plotlyjs="cdn" 으로 크기를 크게 줄인다.
Seaborn 함수에 ax를 안 넘겨 서브플롯이 어긋난다. sns.heatmap(...) 처럼 ax 인자를 생략하면 현재 활성화된 Axes에 그려진다. 여러 그래프를 한 Figure에 배치할 때는 각 Seaborn 함수 호출에 ax=axes[i] 를 명시적으로 지정한다.
관련 문서
이 문서의 예제는 Pandas로 데이터 탐색·정제·집계하기 에서 정제한 것과 같은 형태의 판매 데이터를 사용한다. 시각화로 확인한 상관관계를 통계적으로 검증하는 방법은 다음 편 기술통계와 가설검정에서 이어진다.
참고 자료
Matplotlib 공식 문서 — Quick start guide (2026-08-10 확인)
Seaborn 공식 문서 (2026-08-10 확인)
Plotly Express 공식 문서 (2026-08-10 확인)
Altair 공식 문서 (2026-08-10 확인)
댓글 0
댓글을 불러오는 중…